
昨晚,我们的渲染流水线遇到了一个奇怪的症状:ComfyUI 仍然正常响应 HTTP 请求,任务队列也在运行,但 GPU 利用率甚至不到 1%。整个渲染批次停滞不前,没有任何清晰的错误信息。这篇笔记记录了我们遇到的"wedge"症状,以及我们植入流水线的自动恢复阶梯。
遇到的 Wedge 症状
同时出现三个信号:
- 服务器进程仍然存活,所有端点都能响应 HTTP 请求
- 任务队列"看起来"在运行,但没有渲染输出
- GPU 利用率(gpu_util)连续超过 60 秒为零,尽管队列中有待处理任务
这种症状比完全宕机更危险,因为只检查"是否响应"的监控系统会认为一切正常,而实际上生产已经停滞。
检测方法:不要只相信 HTTP
关键教训是,健康检查必须测量"工作是否在流动",而不仅仅是"服务器是否响应"。因此我们增加了对 gpu_util 的监控——如果队列中有任务,但 gpu_util 连续超过 60 秒为零,系统就判定为 wedge 并立即开始恢复步骤。
COMFY_HEAL 阶梯
检测到 wedge 后,系统会逐步执行恢复阶梯,每轮有 180 秒的时间上限,防止无限重启循环:
| 步骤 | 操作 | 条件 |
|---|---|---|
| 1 | 仅重启卡住的进程(通过 PID 而非名称识别) | 在主 GPU 上检测到 wedge |
| 2 | 切换到同一台机器上的备用 GPU | 重启后仍未恢复工作 |
| 3 | 安全取消整个批次,通知团队 | 前两个步骤均未成功 |
最需要小心的是重启操作——必须只关闭我们自己的进程,通过 PID 定位,绝不能通过程序名称关闭,因为同一台机器上有多个名称相似的服务。
测试结果
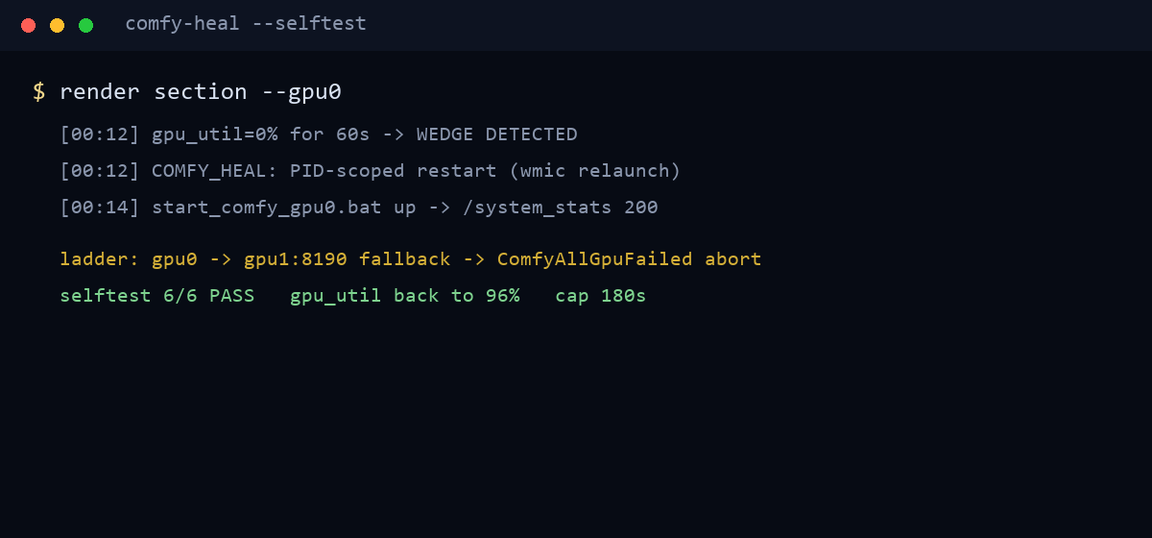
- 离线自测全部通过 6/6 个场景(检测、重启、重新检查、切换备用、时间上限、安全取消)
- 重启机制已在实际视频制作事件中得到验证——卡住的任务被重新渲染并正常播出
- 恢复后 gpu_util 在两分钟内重新达到 96%
下一步计划
下一步是将这种"测量工作流动"的健康检查推广到整个集群的其他服务,并记录每周的 wedge 统计,以观察这种症状是否与特定类型的工作有关——敬请关注下一期 Lab Notes。
