
Đêm qua, pipeline render của chúng tôi gặp hiện tượng kỳ lạ: ComfyUI vẫn phản hồi HTTP bình thường, hàng đợi công việc vẫn chạy, nhưng GPU không tiêu thụ bất kỳ phần trăm nào. Toàn bộ công việc render bị treo mà không có lỗi rõ ràng để xem. Ghi chú này là câu chuyện về hiện tượng "wedge" và thang phục hồi tự động mà chúng tôi đã thêm vào pipeline.
Hiện tượng wedge gặp phải
Có 3 dấu hiệu xuất hiện đồng thời:
- Tiến trình server vẫn sống, phản hồi được mọi yêu cầu HTTP ở tất cả endpoint
- Hàng đợi công việc "dường như" đang chạy nhưng không có render nào chảy ra
- Giá trị sử dụng GPU (gpu_util) liên tục ở mức 0 trong hơn 60 giây, mặc dù hàng đợi có công việc đang chờ
Hiện tượng này nguy hiểm hơn việc tắt hoàn toàn vì hệ thống giám sát (monitor) chỉ kiểm tra "có phản hồi không" sẽ cho rằng mọi thứ bình thường, trong khi sản xuất đã dừng.
Phương pháp phát hiện: Đừng chỉ tin vào HTTP
Bài học quan trọng là health check phải đo "công việc có chảy không" chứ không chỉ "server có phản hồi không". Vì vậy chúng tôi thêm giám sát giá trị gpu_util — nếu hàng đợi có công việc nhưng gpu_util liên tục ở mức 0 trong hơn 60 giây, hệ thống coi đó là wedge và bắt đầu quy trình phục hồi ngay lập tức.
Thang COMFY_HEAL
Khi phát hiện wedge, hệ thống sẽ leo thang phục hồi từng bước, có giới hạn thời gian 180 giây mỗi vòng, không để restart lặp vô tận:
| Bước | Hành động | Điều kiện |
|---|---|---|
| 1 | Restart chỉ tiến trình bị wedge (chỉ định bằng PID, không phải tên) | Phát hiện wedge trên GPU chính |
| 2 | Chuyển sang GPU dự phòng trên cùng máy | Restart rồi vẫn không hoạt động trở lại |
| 3 | Hủy toàn bộ công việc an toàn, thông báo cho team | Hai bước đầu không thành công |
Điểm cần thận trọng nhất là việc restart — phải chỉ đóng tiến trình của riêng chúng tôi, xác định bằng PID, không bao giờ đóng bằng tên chương trình vì trên cùng máy có nhiều service có tên tương tự.
Kết quả kiểm tra
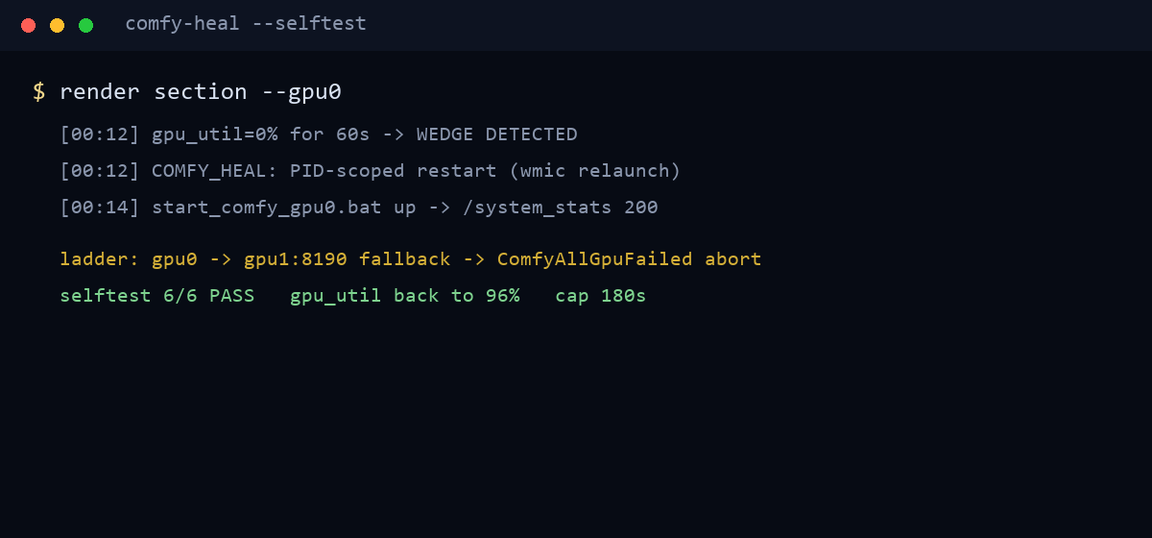
- Selftest offline vượt qua đầy đủ 6/6 trường hợp (phát hiện, restart, kiểm tra lại, chuyển dự phòng, giới hạn thời gian, hủy an toàn)
- Cơ chế restart đã được chứng minh với sự cố thực tế trong quá trình sản xuất clip — công việc bị treo được render lại và phát sóng bình thường
- Sau khi phục hồi, gpu_util trở lại mức 96% trong vòng hai phút
Kế hoạch tiếp theo
Bước tiếp theo là áp dụng loại health check "đo công việc chảy" này cho các service khác trong toàn bộ fleet, bao gồm ghi lại thống kê wedge hàng tuần để xem hiện tượng này có liên quan đặc biệt đến loại công việc nào không — hãy theo dõi trong Lab Notes số tới.
