
어젯밤 우리 렌더 파이프라인이 이상한 증상을 겪었습니다. ComfyUI는 HTTP에 정상적으로 응답했고, 작업 큐도 움직였지만 GPU는 1%의 부하도 받지 않았습니다. 전체 렌더 작업 세트가 에러 메시지도 없이 그대로 멈춰 있었습니다. 이 노트는 "wedge"라는 증상과 파이프라인에 추가한 자동 회복 계단식 시스템에 대한 이야기입니다.
발견된 wedge 증상
동시에 나타난 세 가지 신호:
- 서버 프로세스는 살아있고 모든 엔드포인트에 HTTP 요청에 응답
- 작업 큐가 "움직이는 것처럼" 보이지만 렌더 출력이 전혀 없음
- 대기 중인 작업이 있음에도 gpu_util이 60초 이상 연속으로 0%
이 증상은 완전히 죽는 것보다 더 위험합니다. 단순히 "응답하는지"만 확인하는 모니터링 시스템은 모든 것이 정상이라고 판단하지만, 실제 생산은 멈춰 있기 때문입니다.
감지 방법: HTTP만 믿지 마세요
중요한 교훈은 헬스 체크가 "서버가 응답하는지"가 아니라 "작업이 흐르는지"를 측정해야 한다는 것입니다. 따라서 gpu_util 모니터링을 추가했습니다 — 큐에 작업이 있지만 gpu_util이 60초 이상 연속으로 0%이면 wedge로 판단하고 즉시 회복 절차를 시작합니다.
COMFY_HEAL 계단식 시스템
wedge가 감지되면 시스템은 단계별로 회복을 시도하며, 각 라운드당 180초의 시간 상한을 설정하여 무한 재시작 루프를 방지합니다:
| 단계 | 동작 | 조건 |
|---|---|---|
| 1 | wedge가 걸린 프로세스만 재시작 (PID로 식별, 이름이 아님) | 주요 GPU에서 wedge 감지 |
| 2 | 동일 호스트의 백업 GPU로 전환 | 재시작 후에도 작업이 돌아오지 않음 |
| 3 | 작업 세트 전체를 안전하게 취소하고 팀에 알림 | 첫 두 단계가 실패 |
가장 주의해야 할 점은 재시작입니다 — PID로 위치를 식별하여 우리 프로세스만 종료해야 하며, 프로그램 이름으로 종료하면 안 됩니다. 같은 호스트에는 비슷한 이름을 가진 여러 서비스가 있기 때문입니다.
테스트 결과
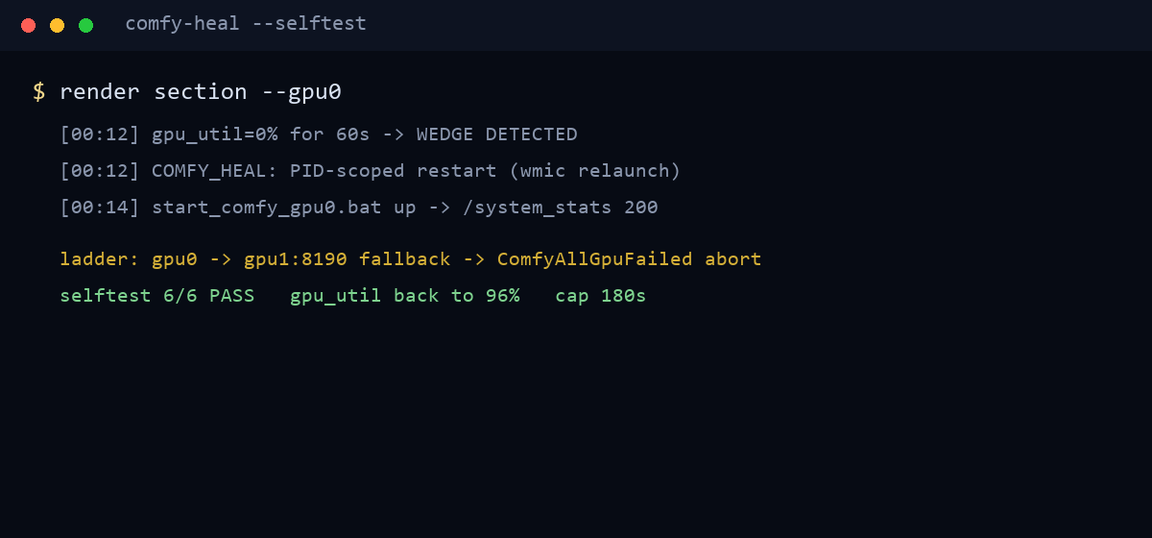
- 오프라인 selftest 6/6 케이스 통과 (감지, 재시작, 재검사, 백업 전환, 시간 상한, 안전한 취소)
- 재시작 메커니즘은 실제 프로덕션 클립 이벤트에서 검증됨 — 멈춰 있던 작업이 다시 렌더링되어 정상적으로 방송됨
- 회복 후 gpu_util이 2분 내에 96%까지 회복
다음 계획
다음 단계는 이 "작업 흐름 측정" 방식의 헬스 체크를 플릿의 다른 서비스에도 적용하는 것입니다. 또한 wedge 발생 주별 통계를 기록하여 이 증상이 특정 유형의 작업과 관련이 있는지 확인합니다 — 다음 Lab Notes에서 계속 다루겠습니다.
