
昨夜、私たちのレンダリングパイプラインが奇妙な症状に見舞われました。ComfyUI は HTTP に通常通り応答し、ジョブキューも動いていましたが、GPU はまったく仕事を処理していませんでした。レンダリングジョブ全体がエラーメッセージもなくただ停止している状態でした。このノートは「ウェッジ」という症状と、パイプラインに組み込んだ自動復旧ラダーについての記録です。
遭遇したウェッジ症状
同時に現れた兆候は3つありました:
- サーバープロセスは生きており、すべてのエンドポイントに HTTP リクエストに応答可能
- ジョブキューは「動いているように見えた」が、レンダリング出力が一切出てこない
- キューに待機ジョブがあるにもかかわらず、GPU 使用率(gpu_util)が60秒以上連続してゼロ
この症状は完全にダウンするよりも危険です。「応答しているか」だけをチェックする監視システムは、生産が停止しているにもかかわらずすべて正常だと判断してしまうからです。
検出方法: HTTP のみには頼らない
重要な教訓は、ヘルスチェックが「サーバーが応答しているか」だけでなく「仕事が流れているか」を測定しなければならないということです。そのため、gpu_util の監視を追加しました — キューにジョブがあるのに gpu_util が60秒以上連続してゼロの場合、システムはウェッジを検出したと判断し、直ちに復旧手順を開始します。
COMFY_HEAL ラダー
ウェッジを検出すると、システムは復旧ラダーを段階的に登っていきます。各ラウンドに180秒の時間制限があり、無限ループでの再起動を防ぎます:
| 段階 | 動作 | 条件 |
|---|---|---|
| 1 | ウェッジに陥ったプロセスのみ再起動(名前ではなく PID で指定) | メインGPUでウェッジを検出 |
| 2 | 同じマシンのバックアップGPUに切り替え | 再起動後も動作が戻らない |
| 3 | ジョブ全体を安全にキャンセル、チームに通知 | 最初の2段階が失敗 |
最も注意が必要なのは再起動です — 自分たちのプロセスのみを PID で特定して終了させなければなりません。プログラム名で終了させることは決してありません。同じマシンには名前が似たサービスが多数存在するからです。
テスト結果
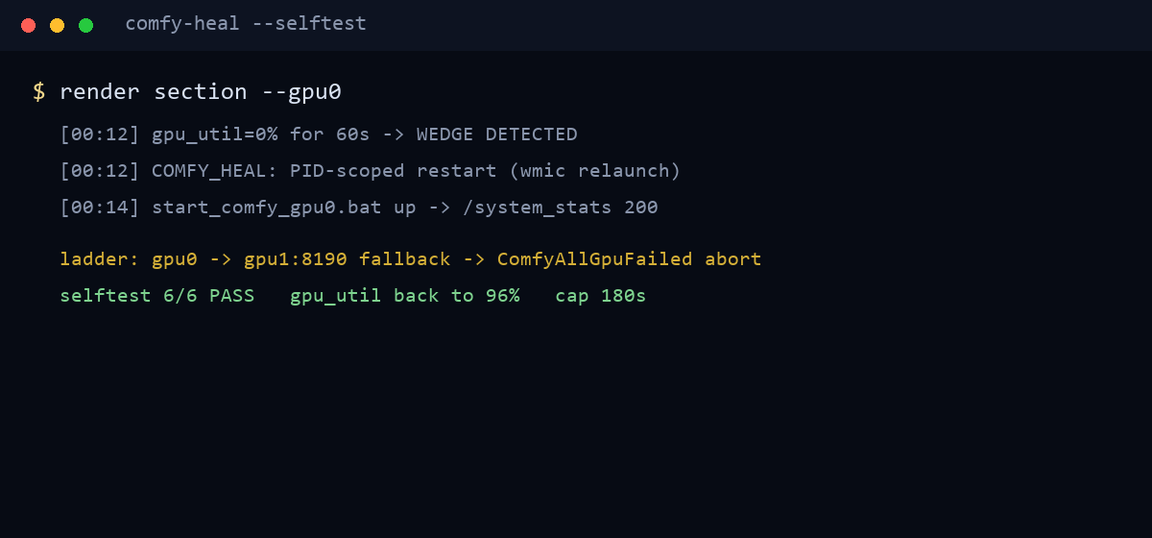
- オフライン selftest を 6/6 ケースすべて通過(検出、再起動、再確認、バックアップ切り替え、時間制限、安全キャンセル)
- 再起動メカニズムはクリップ制作中の実際のインシデントで検証済み — 停止していたジョブは再レンダリングされ、通常通り放送されました
- 復旧後、gpu_util は2分以内に96%に回復
次の計画
次の段階は、この「仕事の流れを測定する」ヘルスチェックを fleet 全体の他のサービスに適用することです。また、ウェッジの週次統計を記録し、この症状が特定のジョブタイプと特に結びついているかどうかを確認します — 続きは次の Lab Notes でどうぞ
