
คืนก่อน render pipeline ของเราเจออาการแปลก: ComfyUI ยังตอบ HTTP ปกติ คิวงานยังเดิน แต่ GPU ไม่กินงานเลยแม้แต่เปอร์เซ็นต์เดียว งานเรนเดอร์ทั้งชุดค้างเฉยๆ โดยไม่มี error สวยๆ ให้ดู บันทึกนี้คือเรื่องราวของอาการ "wedge" และบันไดฟื้นตัวอัตโนมัติที่เราใส่เข้าไปใน pipeline
อาการ wedge ที่เจอ
สัญญาณที่พบมี 3 ข้อพร้อมกัน:
- โปรเซสเซิร์ฟเวอร์ยังมีชีวิต ตอบคำขอ HTTP ได้ทุก endpoint
- คิวงาน "ดูเหมือน" กำลังเดิน แต่ไม่มี render ไหลออกมาเลย
- ค่าการใช้งาน GPU (gpu_util) ติดศูนย์ต่อเนื่องเกิน 60 วินาที ทั้งที่คิวมีงานรออยู่
อาการแบบนี้อันตรายกว่าการดับสนิท เพราะระบบเฝ้าดู (monitor) ที่เช็คแค่ "ตอบไหม" จะมองว่าทุกอย่างปกติ ทั้งที่การผลิตหยุดนิ่ง
วิธีตรวจจับ: อย่าเชื่อ HTTP อย่างเดียว
บทเรียนสำคัญคือ health check ต้องวัด "งานไหลไหม" ไม่ใช่แค่ "เซิร์ฟเวอร์ตอบไหม" เราจึงเพิ่มการเฝ้าค่า gpu_util — ถ้าคิวมีงาน แต่ gpu_util เป็นศูนย์ต่อเนื่องเกิน 60 วินาที ระบบถือว่าเจอ wedge และเริ่มขั้นตอนฟื้นตัวทันที
บันได COMFY_HEAL
เมื่อตรวจพบ wedge ระบบจะไต่บันไดฟื้นตัวทีละขั้น มีเพดานเวลา 180 วินาทีต่อรอบ ไม่ปล่อยให้วนรีสตาร์ทไม่รู้จบ:
| ขั้น | การกระทำ | เงื่อนไข |
|---|---|---|
| 1 | รีสตาร์ทเฉพาะโปรเซสที่ติด wedge (ระบุด้วย PID ไม่ใช่ชื่อ) | พบ wedge บน GPU หลัก |
| 2 | สลับไป GPU สำรองบนเครื่องเดียวกัน | รีสตาร์ทแล้วยังไม่กลับมาทำงาน |
| 3 | ยกเลิกงานทั้งชุดอย่างปลอดภัย แจ้งเตือนทีม | สองขั้นแรกไม่สำเร็จ |
จุดที่ต้องระวังที่สุดคือการรีสตาร์ท — ต้องปิดเฉพาะโปรเซสของเราเองเท่านั้น โดยระบุตำแหน่งจาก PID ไม่เคยปิดด้วยชื่อโปรแกรม เพราะบนเครื่องเดียวกันมีหลาย service ที่ชื่อคล้ายกัน
ผลทดสอบ
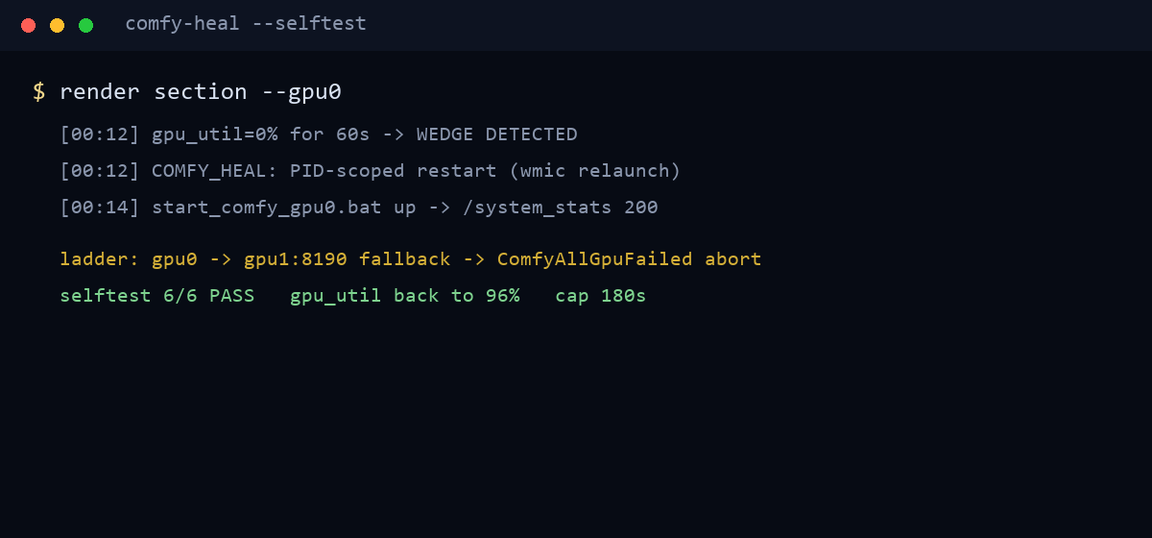
- selftest ออฟไลน์ผ่านครบ 6/6 กรณี (ตรวจจับ, รีสตาร์ท, ตรวจซ้ำ, สลับสำรอง, เพดานเวลา, ยกเลิกปลอดภัย)
- กลไกรีสตาร์ทถูกพิสูจน์แล้วกับเหตุการณ์จริงระหว่างผลิตคลิป — ตัวงานที่ค้างถูกเรนเดอร์ซ้ำและออกอากาศตามปกติ
- หลังฟื้นตัว gpu_util กลับมาแตะ 96% ภายในสองนาที
แผนถัดไป
ขั้นถัดไปคือการยก health check แบบ "วัดงานไหล" นี้ไปใช้กับ service อื่นใน fleet ทั้งหมด รวมถึงบันทึกสถิติ wedge รายสัปดาห์ เพื่อดูว่าอาการนี้ผูกกับงานชนิดไหนเป็นพิเศษหรือไม่ — ติดตามได้ใน Lab Notes ฉบับถัดไป
