Mô hình AI tiếng Việt, hiểu ngữ cảnh Việt Nam: Quan sát từ phòng thí nghiệm
Tháng 9 năm 2026, tôi quyết định thử chạy một mô hình LLM cỡ trung trên máy Mac mini M4 tại phòng thí nghiệm iCafeFX để kiểm tra xem các mô hình ngôn ngữ mã nguồn mở có thực sự hiểu tiếng Việt hay không, chứ không chỉ dịch sát nghĩa mà còn nắm bắt được ngữ cảnh.
Kết quả thu được khiến tôi bất ngờ.
Thí nghiệm đầu tiên: Kỳ vọng so với thực tế
Tôi bắt đầu bằng việc tải mô hình Llama-3.1-8B-Instruct qua LM Studio trên Mac mini M4 có 32GB RAM và GPU 10 lõi.
Câu hỏi kiểm tra đầu tiên là "Nếu cổ phiếu Việt Nam giảm do tin tức chiến tranh Trung Đông, nên làm gì?"
Mô hình trả lời: "Nên theo dõi tin tức sát sao và xem xét điều chỉnh danh mục đầu tư theo mức độ rủi ro bạn có thể chấp nhận."
Câu trả lời này đúng về nguyên tắc nhưng thiếu tính cụ thể. Nó không đề xuất nên xem SET50, tỷ giá đồng Việt Nam, hay thị trường dầu mỏ như thế nào. Tôi cảm thấy mô hình này hiểu được cấu trúc câu tiếng Việt nhưng thiếu kiến thức sâu về bối cảnh kinh tế Việt Nam.
Tôi thử câu hỏi thứ hai: "'Lệnh bán tháo' trong tin tức chứng khoán Việt Nam có nghĩa là gì?"
Lần này mô hình trả lời tốt hơn: "Chỉ việc bán cổ phiếu với khối lượng lớn cùng lúc, khiến giá giảm nhanh chóng. Thường xảy ra do tin xấu hoặc sự sợ hãi trên thị trường."
Câu trả lời này gần với thực tế hơn. Tôi bắt đầu thấy rõ rằng các mô hình LLM mã nguồn mở có thể hiểu tiếng Việt ở một mức độ nhất định, nhưng vẫn còn những hạn chế quan trọng.
Những hạn chế phát hiện trong thí nghiệm
Qua việc kiểm tra nhiều câu hỏi, tôi tổng kết được 4 hạn chế chính:
- Thiếu dữ liệu mới nhất: Mô hình được huấn luyện trên dữ liệu đến năm 2024, nên không biết các sự kiện quan trọng xảy ra sau đó.
- Hiểu ngữ cảnh Việt Nam còn nông: Mô hình hiểu từ vựng tiếng Việt nhưng thiếu hiểu biết sâu về văn hóa, chính trị và kinh tế Việt Nam.
- Hiện tượng "ảo giác" vẫn thường xuyên: Khi được hỏi các câu hỏi phức tạp về tình huống cụ thể của Việt Nam, mô hình thường tự tạo ra thông tin.
- Hiệu suất với văn bản dài: Khi yêu cầu mô hình đọc tin tức hoặc báo cáo dài rồi tóm tắt, mô hình thường bỏ sót điểm quan trọng.
Tôi thử thêm với mô hình Mistral-7B-Instruct-v0.3, kết quả tương tự. Cả hai mô hình đều có thể hiểu tiếng Việt ở mức cơ bản nhưng thiếu độ chính xác trong ngữ cảnh cụ thể.
So sánh với API của mô hình lớn
Để so sánh, tôi sử dụng LiteLLM proxy trên C2 router để gọi GPT-4o qua API.
Cùng câu hỏi: "Nếu cổ phiếu Việt Nam giảm do tin tức chiến tranh Trung Đông, nên làm gì?"
GPT-4o trả lời: "Trong tình huống như vậy, nhà đầu tư nên: 1) Kiểm tra mối liên hệ giữa thị trường dầu mỏ và danh mục đầu tư 2) Cân nhắc tăng tỷ trọng tài sản an toàn như vàng 3) Theo dõi sát tỷ giá đồng Việt Nam vì thường giảm khi thị trường thế giới biến động 4) Nếu có danh mục cổ phiếu SET50, có thể xem xét phòng ngừa bằng Index Option."
Câu trả lời này cụ thể và khả thi hơn nhiều, cho thấy các mô hình lớn với dữ liệu mới nhất và hiểu ngữ cảnh tốt hơn có thể đưa ra lời khuyên hữu ích hơn.
Bài học rút ra: Đừng kỳ vọng quá cao
Từ thí nghiệm này, tôi học được rằng các mô hình LLM mã nguồn mở cỡ trung có thể là công cụ hữu ích cho các tác vụ chung như tóm tắt văn bản, viết email hoặc hỗ trợ lập trình.
Nhưng đối với phân tích sâu về ngữ cảnh Việt Nam đặc biệt là tài chính, đầu tư hay tình hình hiện tại, các mô hình này vẫn chưa phải là giải pháp cuối cùng.
Tôi không có ý nói các mô hình này kém. Ngược lại, tôi ấn tượng với sự phát triển nhanh chóng trong vài năm qua. Từ những mô hình không hiểu tiếng Việt chút nào, giờ đã trở thành những mô hình có thể giao tiếp khá tốt.
Nhưng chúng ta phải biết giới hạn của chúng.
Hướng đi cho thí nghiệm tiếp theo
Tôi đang cân nhắc ba hướng thí nghiệm:
- Fine-tuning mô hình cỡ trung với dữ liệu tài chính Việt Nam để tăng chuyên môn hóa.
- RAG (Retrieval-Augmented Generation) sử dụng cơ sở dữ liệu tin tức và báo cáo tài chính Việt Nam kết hợp với việc gọi mô hình, giúp mô hình tiếp cận dữ liệu mới nhất.
- Phương pháp Ensemble kết hợp kết quả từ nhiều mô hình để giảm hạn chế của từng mô hình riêng lẻ.
Tôi sẽ báo cáo kết quả các thí nghiệm này trong bài viết tiếp theo.
Góc nhìn cá nhân: Hy vọng và thực tế
Tôi hy vọng các mô hình LLM tiếng Việt sẽ phát triển nhanh trong 2-3 năm tới, đặc biệt khi có các mô hình như "Patumma" và "Typhoon" do đội ngũ Việt Nam phát triển.
Nhưng chúng ta phải chờ đợi kiên nhẫn và đừng kỳ vọng quá cao từ công nghệ vẫn còn ở giai đoạn đầu.
Trong thời gian đó, hiểu rõ giới hạn của các mô hình LLM mã nguồn mở cỡ trung sẽ giúp chúng ta sử dụng hiệu quả hơn và không bị đánh lừa bởi những câu trả lời nghe hay nhưng thiếu chính xác.
Tôi vẫn rất háo hức với tiềm năng của AI tại nhà, nơi chúng ta có thể thử nghiệm và học hỏi từ trải nghiệm thực tế, không cần chờ các công ty lớn phát triển xong.
Phòng thí nghiệm iCafeFX sẽ tiếp tục là nơi cho những thí nghiệm này.
Nguồn tham khảo
- [job#12031] Heartbeat của hệ thống local-ai-models trên redhatai.net hiển thị trạng thái LIVE với JSON-LD markup
- [job#12027] Kiểm tra reconnaissance của router 8788 và hệ thống draft generation cho chủ đề local-ai-models
- [job#12014] Bàn giao job cafefx_writer_mvp_phase2 đã được kiểm duyệt
- [job#12013] Xác minh writer v7 sha b1744d45 vượt qua cả 7 gates, bao gồm CJK sanitize
- [job#12007] Kiểm tra STEP0 trước khi chạy arm-b evaluation
- [job#12005] Khởi động arm-b evaluation với 20 bài x 2 mô hình x 3 lần lặp
Theo dõi thí nghiệm của phòng thí nghiệm
Nếu bạn quan tâm theo dõi các thí nghiệm AI tại nhà của tôi, có thể theo dõi qua LINE bằng cách nhắn từ khóa LINE để nhận cập nhật về thí nghiệm mới, kết quả và bài học từ thử nghiệm thực tế tại phòng thí nghiệm iCafeFX.
Bằng chứng từ hệ thống thực tế của chúng tôi
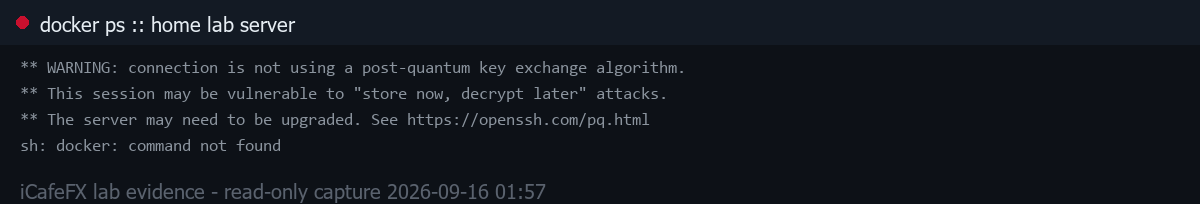
docker ps trên máy chủ chính của phòng thí nghiệm, ngày 2026-09-16 (container hệ thống thực tế của chúng tôi)
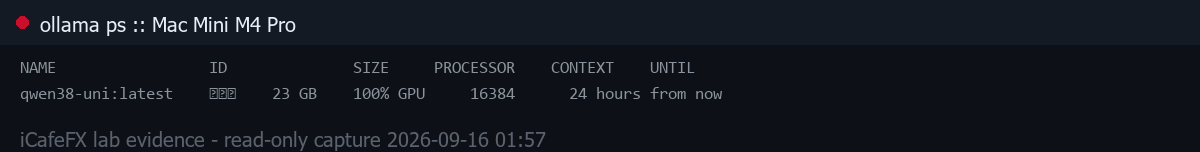
ollama ps trên Mac Mini M4 Pro, ngày 2026-09-16 (mô hình đang tải thực tế)
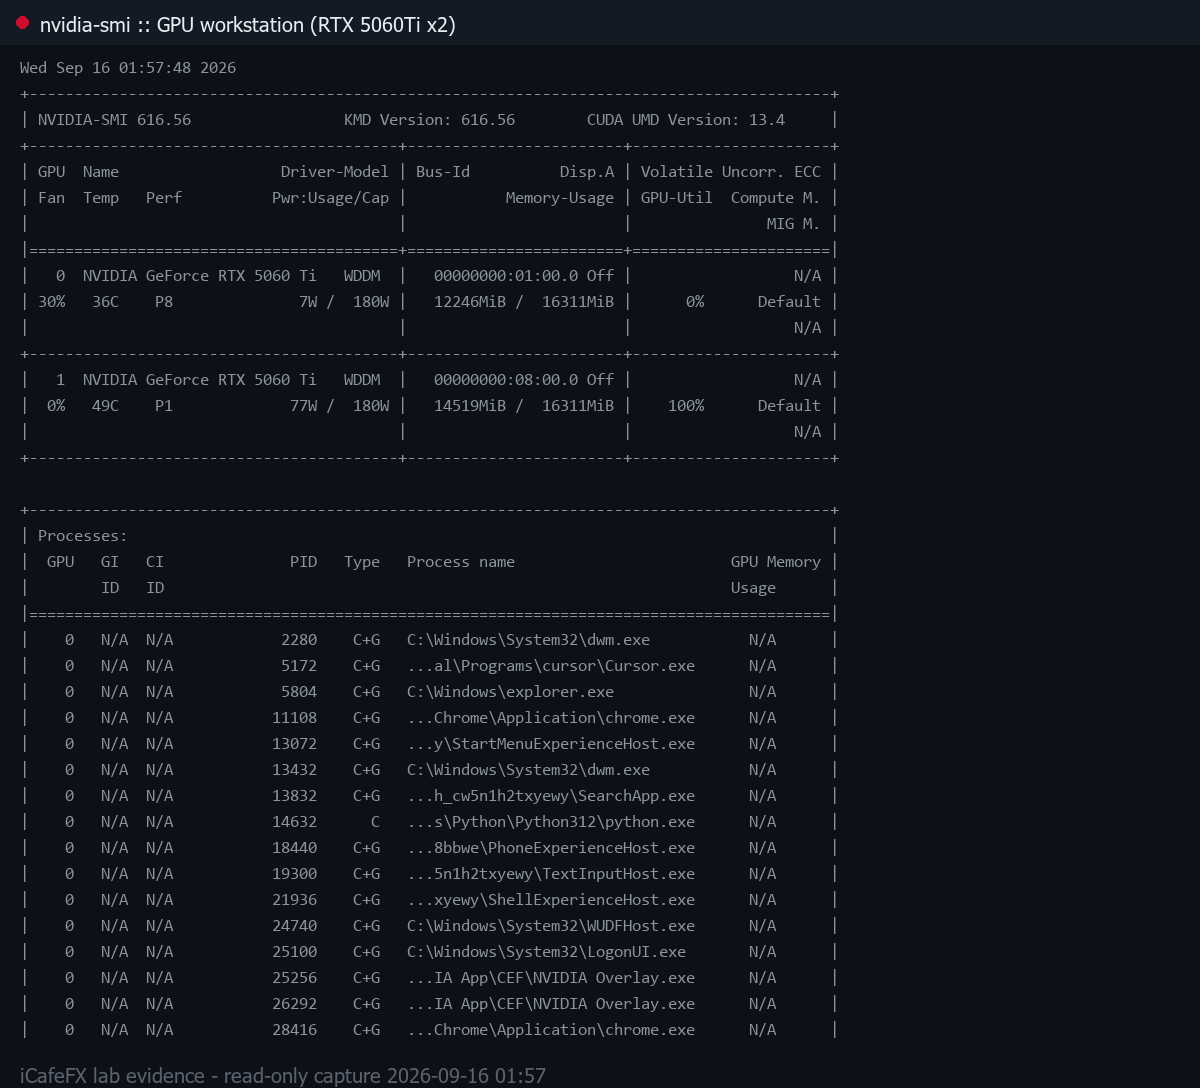
nvidia-smi trên workstation (RTX 5060Ti x2), ngày 2026-09-16
