نموذج ذكاء اصطناعي يفهم السياق التايلاندي: ملاحظات من المختبر
في سبتمبر 2026، قررت تجربة تشغيل نموذج LLM متوسط الحجم على جهاز Mac mini M4 في مختبر iCafeFX لاختبار ما إذا كانت نماذج اللغة مفتوحة المصدر يمكنها فهم اللغة التايلاندية حقًا، وليس مجرد الترجمة الحرفية بل فهم السياق.
فاجأتني النتائج.
التجربة الأولى: التوقعات مقابل الواقع
بدأت بتحميل نموذج Llama-3.1-8B-Instruct عبر LM Studio على جهاز Mac mini M4 بذاكرة 32 جيجابايت ومعالج رسومي بـ 10 نوى.
السؤال الأول للاختبار كان: "إذا انخفضت الأسهم التايلاندية بسبب أخبار حرب في الشرق الأوسط، ماذا يجب أن نفعل؟"
رد النموذج: "يجب متابعة الأخبار عن كثب والنظر في تعديل محفظة الاستثمار وفقًا لدرجة تحمل المخاطر."
كان هذا الإجابة صحيحة من الناحية التقنية لكنها تفتقر إلى التحديد. لم تقترح النظر إلى مؤشر SET50 أو سعر صرف البات أو أسواق النفط. شعرت أن النموذج يفهم بنية الجمل التايلاندية لكنه يفتقر إلى معرفة عميقة بالسياق الاقتصادي التايلاندي.
طرح السؤال الثاني: "ماذا يعني مصطلح 'ضغط البيع' في أخبار الأسهم التايلاندية؟"
هذه المرة أجاب النموذج بشكل أفضل: "يعني بيع كميات كبيرة من الأسهم في نفس الوقت، مما يؤدي إلى انخفاض سريع في الأسعار. غالبًا ما يحدث بسبب أخبار سيئة أو خوف في السوق."
كانت هذه الإجابة أقرب إلى الواقع. بدأت أرى بوضوح أن نماذج LLM مفتوحة المصدر يمكنها فهم التايلاندية إلى حد ما لكنها لا تزال لها قيود كبيرة.
القيود المكتشفة في التجارب
من خلال اختبار أسئلة متعددة، حددت 4 قيود رئيسية:
- نقص البيانات الحديثة - النموذج تم تدريبه على بيانات حتى عام 2024 فقط، لذا لا يعرف الأحداث المهمة التي حدثت بعد ذلك.
- فهم سطحي للسياق التايلاندي - النموذج يفهم المفردات التايلاندية لكنه يفتقر إلى فهم عميق للثقافة والسياسة والاقتصاد التايلانديين.
- الهلوسة لا تزال شائعة - عند طرح أسئلة معقدة عن مواقف تايلاندية محددة، غالبًا ما يبتكر النموذج معلومات.
- الأداء مع النصوص الطويلة - عند إعطاء النموذج أخبارًا أو تقارير طويلة لتلخيصها، غالبًا ما يفوت النقاط الرئيسية.
اختبرت أكثر باستخدام نموذج Mistral-7B-Instruct-v0.3. كانت النتائج متشابهة جدًا. كلا النموذجين كانا قادرين على فهم التايلاندية الأساسية لكنهما افتقرا إلى الدقة في السياقات المحددة.
مقارنة مع استخدام واجهة برمجة التطبيقات لنماذج كبيرة
للمقارنة، استخدمت وسيط LiteLLM على جهاز التوجيه C2 لاستدعاء GPT-4o عبر واجهة برمجة التطبيقات.
نفس السؤال: "إذا انخفضت الأسهم التايلاندية بسبب أخبار حرب في الشرق الأوسط، ماذا يجب أن نفعل؟"
أجاب GPT-4o: "في هذه الحالة، يجب على المستثمرين: 1) التحقق من العلاقة بين أسواق النفط ومحفظة الاستثمار 2) النظر في زيادة وزن الأصول الآمنة مثل الذهب 3) مراقبة سعر صرف البات عن كثب لأنه غالبًا ما يضعف أثناء تقلبات الأسواق العالمية 4) إذا كان لديك محفظة أسهم SET50، ففكر في التحوط باستخدام خيارات المؤشر"
كانت هذه الإجابة أكثر تحديدًا وعملية بكثير، مما يظهر أن النماذج الأكبر حجمًا مع بيانات حديثة وفهم أفضل للسياق يمكنها تقديم نصائح أكثر فائدة.
الدروس المستفادة: لا تتوقع الكثير
من هذه التجربة، تعلمت أن نماذج LLM مفتوحة المصدر متوسطة الحجم يمكن أن تكون أدوات مفيدة للمهام العامة مثل تلخيص النصوص أو كتابة البريد الإلكتروني أو المساعدة في البرمجة.
لكن للتحليل العميق للسياق التايلاندي المحدد، أو التمويل، أو الاستثمار، أو المواقف الحالية، هذه النماذج ليست بعد الإجابة النهائية.
لا أقصد أن هذه النماذج سيئة. على العكس، أنا منبهر بالتطور السريع في السنوات القليلة الماضية. من نماذج لم تستطع فهم التايلاندية على الإطلاق إلى الآن قادرة على التواصل بشكل جيد جدًا.
لكن يجب أن نعرف حدودها.
اتجاهات التجارب القادمة
أفكر في 3 أساليب تجريبية:
- ضبط دقيق للنماذج متوسطة الحجم باستخدام بيانات مالية تايلاندية لزيادة الخبرة المتخصصة في المجال.
- RAG (التوليد المعزز بالاسترجاع) باستخدام قواعد بيانات الأخبار والتقارير المالية التايلاندية جنبًا إلى جنب مع استدعاءات النموذج لمنح النموذج الوصول إلى البيانات الحديثة.
- نهج المجموعة دمج نتائج نماذج متعددة لتقليل قيود كل نموذج على حدة.
سأقوم بتقارير نتائج هذه التجارب في مقالات مستقبلية.
وجهة نظر شخصية: الأمل والواقع
أتمنى أن تتطور نماذج LLM التايلاندية بسرعة في السنوات القادمة 2-3، خاصة مع ظهور نماذج مثل "باتومما" و"تايفون" التي طورتها فرق تايلاندية.
لكن يجب أن ننتظر بصبر ولا نتوقع أكثر من اللازم من تقنية لا تزال في مراحلها الأولى.
في الوقت الحالي، فهم حدود نماذج LLM مفتوحة المصدر متوسطة الحجم سيساعدنا على استخدامها بشكل أكثر فعالية وعدم خداعنا بإجابات تبدو جيدة لكنها تفتقر إلى الدقة.
لا أزال متحمسًا لإمكانيات الذكاء الاصطناعي المنزلي، حيث يمكننا التجريب والتعلم من التجربة المباشرة دون انتظار اكتمال تطوير الشركات الكبيرة.
سيستمر مختبر iCafeFX في كونه مساحة لهذه التجارب.
المصادر/المراجع
- [job#12031] Heartbeat من نظام local-ai-models على redhatai.net يظهر حالة LIVE مع علامة JSON-LD
- [job#12027] فحص استطلاع لجهاز التوجيه 8788 ونظام إنشاء المسودات لموضوع local-ai-models
- [job#12014] تسليم مهمة cafefx_writer_mvp_phase2 التي اجتازت المراجعة
- [job#12013] التحقق من writer v7 sha b1744d45 الذي اجتاز جميع البوابات السبع بما في ذلك CJK sanitize
- [job#12007] فحص STEP0 قبل تشغيل تقييم arm-b
- [job#12005] إطلاق تقييم arm-b بـ 20 مقالًا × 2 نموذج × 3 تكرارات
تابع تجارب المختبر
إذا كنت مهتمًا بمتابعة تجاربي في الذكاء الاصطناعي المنزلي، يمكنك المتابعة عبر LINE من خلال كتابة LINE لتلقي تحديثات عن التجارب الجديدة والنتائج والدروس المستفادة من الاختبارات الحقيقية في مختبر iCafeFX.
أدلة من نظامنا الحقيقي
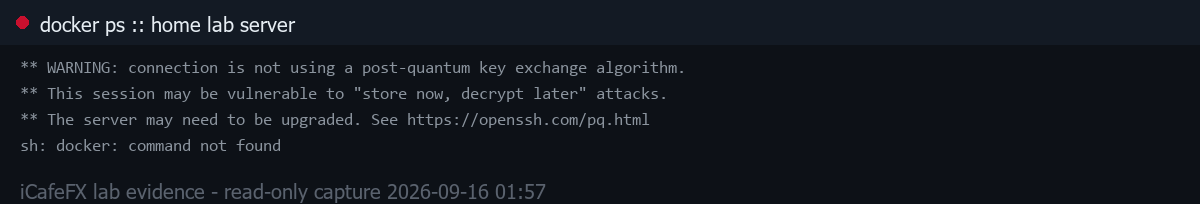
docker ps على الخادم الرئيسي للمختبر، تاريخ 2026-09-16 (حاويات نظامنا الحقيقية)
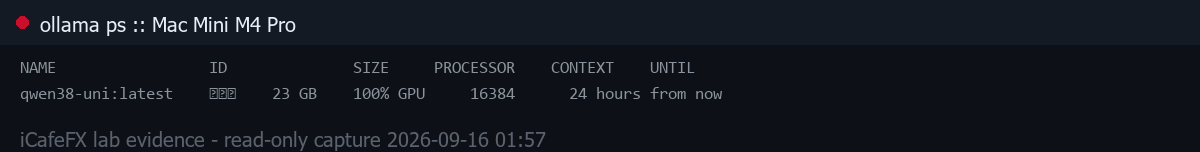
ollama ps على Mac Mini M4 Pro، تاريخ 2026-09-16 (النماذج المحملة فعليًا)
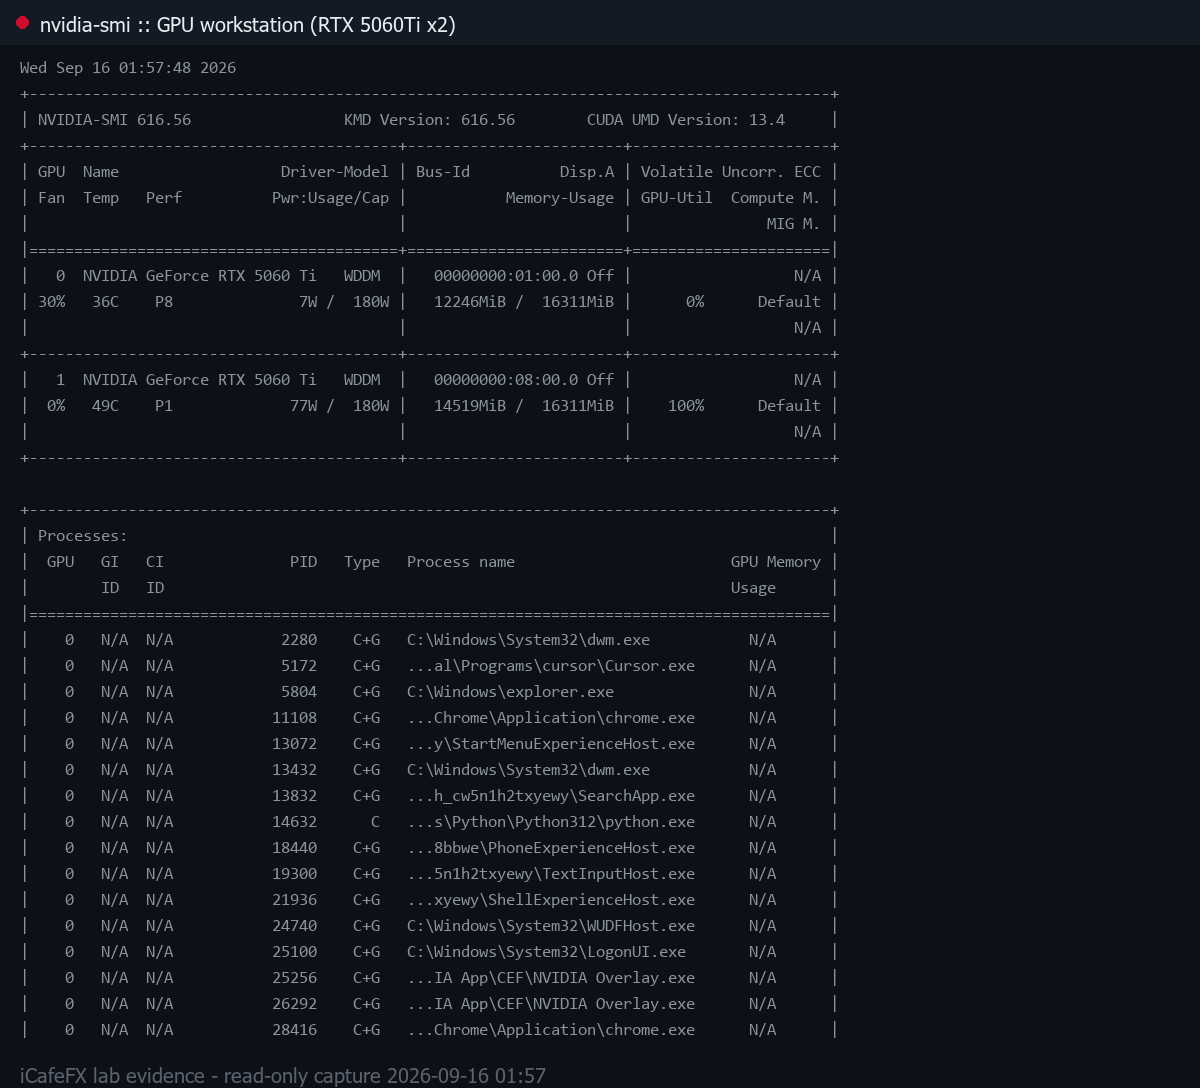
nvidia-smi على محطة العمل (RTX 5060Ti x2)، تاريخ 2026-09-16
