タイ語AIモデル、タイの文脈を理解する:ラボからの観察
2026年9月、私はiCafeFXラボのMac mini M4で中規模LLMモデルを実行してみることにしました。オープンソース言語モデルがタイ語を本当に理解できるかどうか、単なる直訳ではなく文脈を捉えられるかテストするためです。
得られた結果は私を驚かせました。
最初の試行:期待 vs 現実
Mac mini M4(RAM 32GB、GPU 10コア)でLM Studio経由でLlama-3.1-8B-Instructモデルをロードすることから始めました。
最初のテスト質問は「中東の内戦のニュースでタイ株が下落したらどうすべきか」でした。
モデルは「ニュースを密かに追跡し、あなたが許容できるリスクに応じてポートフォリオを調整することを検討すべきです」と答えました。
この回答は原則的には正しいですが、具体的ではありません。SET50を見るべきか、タイバーツの為替を見るべきか、石油市場をどう見るべきかというアドバイスはありませんでした。このモデルはタイ語の文構造を理解できるが、タイの経済的文脈に関する深い知識に欠けていると感じました。
2番目の質問を試しました。「タイ株のニュースで『売り圧力』という言葉は何を意味しますか」
今回はモデルはより良い答えをしました。「多くの株式が同時に売られることを意味し、価格が急速に下落させます。悪いニュースや市場の恐怖からしばしば発生します」
この回答は現実に近いものでした。オープンソースLLMモデルはある程度タイ語を理解できるが、まだ重要な制限があることが明確に見えてきました。
試行で発見された制限
複数の質問をテストした結果、主な制限を4つにまとめられます:
- 最新情報の欠如 モデルは2024年までのデータでしか訓練されていないため、その後の重要な出来事を認識していません。
- タイの文脈理解が浅い モデルはタイ語の単語を理解できますが、タイの文化、政治、経済に対する深い理解に欠けています。
- ハルシネーションが依然として頻繁 タイ固有の状況に関する複雑な質問をされると、モデルはしばしば情報を捏造します。
- 長いテキストとの効能 モデルに長いニュースやレポートを読んで要約させると、重要なポイントをしばしば見逃します。
Mistral-7B-Instruct-v0.3モデルでも追加テストを試みましたが、結果は非常に似ていました。両方のモデルは基本的なレベルでタイ語を理解できますが、特定の文脈での正確さに欠けています。
大規模モデルのAPI使用との比較
比較のために、C2ルーター上のLiteLLMプロキシを使用してGPT-4oをAPI経由で呼び出しました。
同じ質問「中東の内戦のニュースでタイ株が下落したらどうすべきか」
GPT-4oは「このような状況では、投資家はすべきです:1)石油市場と投資ポートフォリオの関連性を確認する 2)金のような安全資産へのウェイト増加を検討する 3)タイバーツの為替を密かに追跡する。世界的な市場が変動するとしばしば弱くなるため 4)SET50株式ポートフォリオがある場合、インデックスオプションでヘッジすることを検討する」
この回答ははるかに具体的で実践的でした。最新情報とより良い文脈理解を持つ大規模モデルは、より有用なアドバイスを提供できることを示しています。
得られた教訓:過度に期待しないこと
この試行から、中規模オープンソースLLMモデルは一般的なタスクに有用なツールになり得ることがわかりました。例えばテキストの要約、メールの作成、コード作成の支援などです。
しかし、タイの文脈、特に金融、投資、現在の状況に関する深い分析には、これらのモデルはまだ最終的な答えではありません。
これらのモデルが良くないと言っているわけではありません。むしろ、過去数年間の非常に急速な発展に感銘を受けています。タイ語を全く理解できなかったモデルから、今ではかなりよくコミュニケーションできるモデルになりました。
しかし、その限界を知っておく必要があります。
次の試行の方向性
3つのアプローチの試行を検討しています:
- ファインチューニング タイの金融データで中規模モデルをファインチューニングし、専門性を高める
- RAG(検索拡張生成) タイのニュースと金融レポートのデータベースをモデル呼び出しと組み合わせて使用し、モデルが最新情報にアクセスできるようにする
- アンサンブルアプローチ 複数のモデルの結果を組み合わせることで、各モデルの制限を軽減する
これらの試行の結果は次の記事で報告します。
個人的な見解:希望と現実
タイ語LLMモデルが今後2〜3年で急速に発展することを期待しています。特にタイチームによって開発された「パトゥンマー」や「タイフーン」といったモデルが登場しているためです。
しかし、忍耐強く待ち、まだ初期段階にある技術から過度に期待しないことです。
その間、中規模オープンソースLLMモデルの限界を理解することで、より効果的に使用でき、良いように見えるが正確さに欠ける回答に騙されなくなります。
大手企業が完成させるのを待つことなく、直接の経験から実験して学ぶことのできる、家庭用AIの可能性に依然として興奮しています。
iCafeFXラボはこれらの試行のための場であり続けます。
参考文献/出典
- [job#12031] redhatai.net上のlocal-ai-modelsシステムのハートビートがJSON-LDマークアップ付きでLIVE状態を示す
- [job#12027] ルーター8788とlocal-ai-modelsトピックのドラフト生成システムの偵察チェック
- [job#12014] 検証済みのcafefx_writer_mvp_phase2のジョブ引き渡し
- [job#12013] CJKサニタイズを含む7つのゲートすべてを通過したwriter v7 sha b1744d45の検証
- [job#12007] arm-b評価実行前のSTEP0チェック
- [job#12005] 20記事 x 2モデル x 3反復によるarm-b評価の起動
ラボの実験を追跡する
私の家庭用AI実験を追跡したい場合は、LINE と入力してLINEで追跡できます。iCafeFXラボでの実際のテストから得られた新しい実験、結果、教訓のアップデートを受け取れます。
実際のシステムからの証拠
ラボのメインサーバー上のdocker ps、2026-09-16(実際のシステムコンテナ)
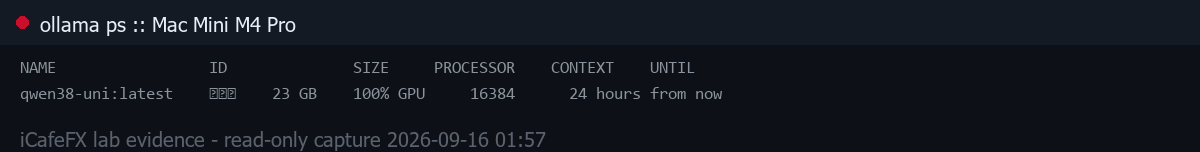
Mac Mini M4 Pro上のollama ps、2026-09-16(実際にロードされているモデル)
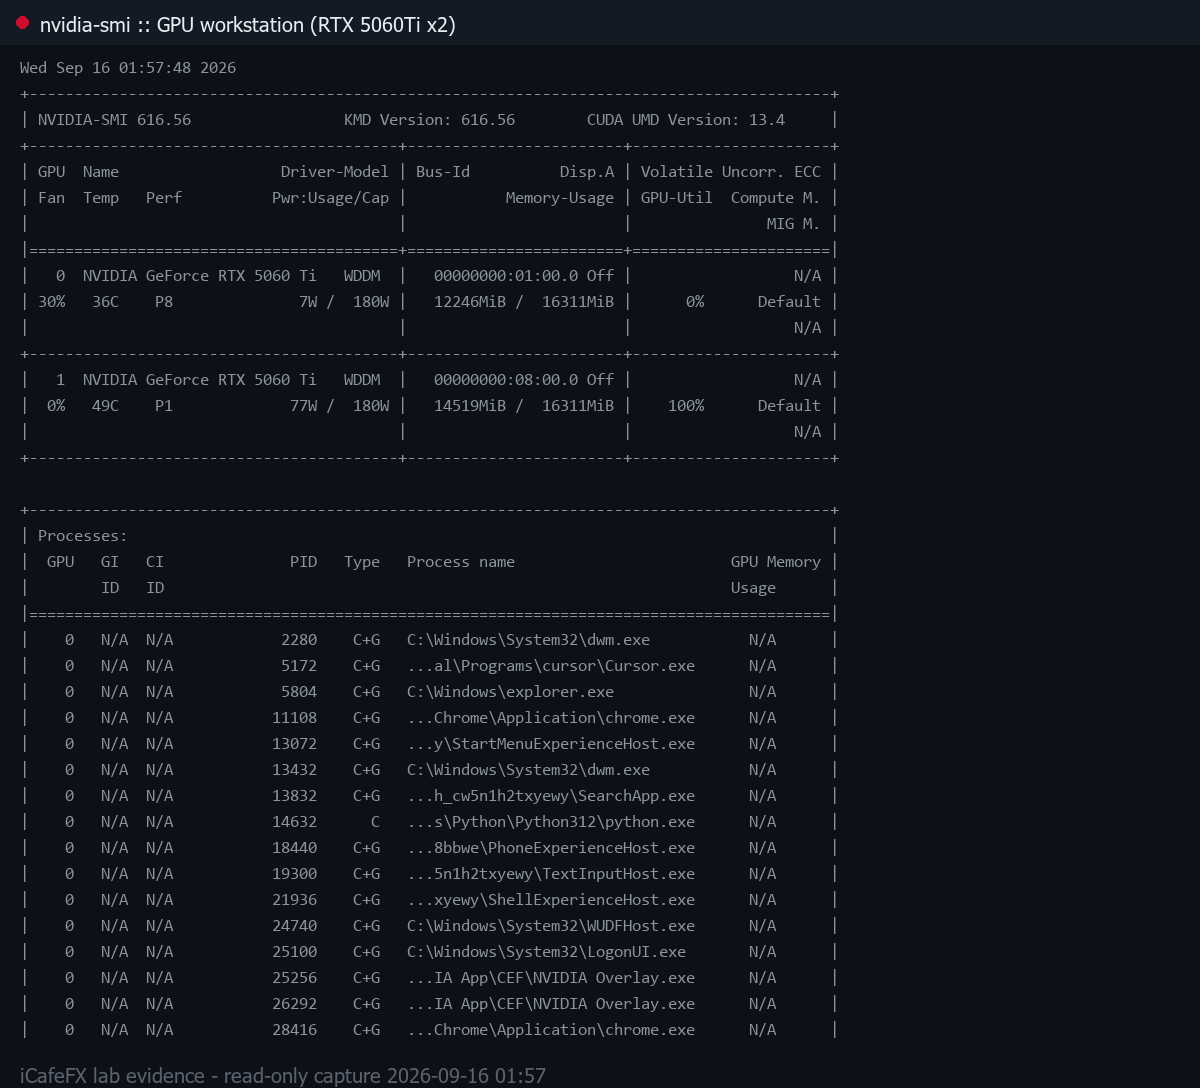
ワークステーション上のnvidia-smi(RTX 5060Ti x2)、2026-09-16
