โมเดล AI ภาษาไทย เข้าใจบริบทไทย: ข้อสังเกตจากห้องแล็บ
เมื่อเดือนกันยายน 2026 ผมตัดสินใจลองรันโมเดล LLM ขนาดกลางบนเครื่อง Mac mini M4 ในแล็บ iCafeFX ดู เพื่อทดสอบว่าโมเดลภาษาแบบ open-source สามารถเข้าใจภาษาไทยได้จริงหรือไม่ ไม่ใช่แค่แปลตรงตัว แต่จับบริบทได้
ผลลัพธ์ที่ได้ทำให้ผมประหลาดใจ
การทดลองครั้งแรก: ความคาดหวัง vs ความจริง
ผมเริ่มจากการโหลดโมเดล Llama-3.1-8B-Instruct ผ่าน LM Studio บน Mac mini M4 ที่มี RAM 32GB และ GPU 10-core
คำถามทดสอบแรกคือ "ถ้าหุ้นไทยร่วงเพราะข่าวสงครามกลางตะวันออกกลาง ควรทำอย่างไร"
โมเดลตอบกลับมาว่า "ควรติดตามข่าวสารอย่างใกล้ชิด และพิจารณาปรับพอร์ตการลงทุนตามความเสี่ยงที่คุณยอมรับได้"
คำตอบนี้ถูกต้องตามหลักการ แต่ขาดความเฉพาะเจาะจง มันไม่ได้แนะนำว่าควรดู SET50, ดูค่าเงินบาท, หรือดูตลาดน้ำมันอย่างไร ผมรู้สึกว่าโมเดลนี้เข้าใจโครงสร้างประโยคไทยได้ แต่ขาดความรู้เชิงลึกเกี่ยวกับบริบททางเศรษฐกิจของไทย
ผมลองคำถามที่สอง "คำว่า 'แรงเทขาย' ในข่าวหุ้นไทยหมายถึงอะไร"
คราวนี้โมเดลตอบได้ดีขึ้น "หมายถึงการขายหุ้นจำนวนมากพร้อมกัน ทำให้ราคาตกอย่างรวดเร็ว มักเกิดจากข่าวร้ายหรือความกลัวในตลาด"
คำตอบนี้ใกล้เคียงความจริง ผมเริ่มเห็นภาพชัดเจนว่าโมเดล LLM open-source สามารถเข้าใจภาษาไทยในระดับหนึ่ง แต่ยังมีข้อจำกัดสำคัญ
ข้อจำกัดที่พบในการทดลอง
จากการทดสอบหลายคำถาม ผมสรุปข้อจำกัดหลักได้ 4 ประการ:
- ขาดข้อมูลล่าสุด โมเดลถูกเทรนด้วยข้อมูลจนถึงปี 2024 เท่านั้น ทำให้ไม่รู้จักเหตุการณ์สำคัญที่เกิดขึ้นหลังจากนั้น
- ความเข้าใจบริบทไทยตื้น โมเดลเข้าใจคำศัพท์ไทยได้ แต่ขาดความเข้าใจในวัฒนธรรม การเมือง และเศรษฐกิจไทยอย่างลึกซึ้ง
- Hallucination ยังพบได้บ่อย เมื่อถูกถามคำถามที่ซับซ้อนเกี่ยวกับสถานการณ์เฉพาะของประเทศไทย โมเดลมักสร้างข้อมูลขึ้นมาเอง
- ประสิทธิภาพกับข้อความยาว เมื่อให้โมเดลอ่านข่าวหรือรายงานยาวๆ แล้วสรุป โมเดลมักพลาดจุดสำคัญ
ผมลองทดสอบเพิ่มเติมด้วยโมเดล Mistral-7B-Instruct-v0.3 ผลลัพธ์คล้ายกันมาก โมเดลทั้งสองสามารถเข้าใจภาษาไทยในระดับพื้นฐานได้ แต่ขาดความแม่นยำในบริบทเฉพาะ
การเปรียบเทียบกับการใช้ API ของโมเดลขนาดใหญ่
เพื่อเปรียบเทียบ ผมใช้ LiteLLM proxy บน C2 router เพื่อเรียกใช้ GPT-4o ผ่าน API
คำถามเดียวกัน "ถ้าหุ้นไทยร่วงเพราะข่าวสงครามกลางตะวันออกกลาง ควรทำอย่างไร"
GPT-4o ตอบว่า "ในสถานการณ์เช่นนี้ นักลงทุนควร: 1) ตรวจสอบความเชื่อมโยงระหว่างตลาดน้ำมันกับพอร์ตลงทุน 2) พิจารณาเพิ่มน้ำหนักให้สินทรัพย์ปลอดภัยเช่นทองคำ 3) ติดตามค่าเงินบาทอย่างใกล้ชิด เพราะมักอ่อนค่าเมื่อตลาดโลกผันผวน 4) ถ้ามีพอร์ตหุ้น SET50 อาจพิจารณา Hedge ด้วย Index Option"
คำตอบนี้เจาะจงและปฏิบัติได้จริงกว่ามาก แสดงให้เห็นว่าโมเดลขนาดใหญ่ที่มีข้อมูลล่าสุดและความเข้าใจบริบทที่ดีกว่า สามารถให้คำแนะนำที่มีประโยชน์มากกว่า
บทเรียนที่ได้: อย่าคาดหวังมากเกินไป
จากการทดลองนี้ ผมเรียนรู้ว่าโมเดล LLM open-source ขนาดกลางสามารถเป็นเครื่องมือที่มีประโยชน์สำหรับงานทั่วไป เช่น การสรุปข้อความ การเขียนอีเมล หรือการช่วยเขียนโค้ด
แต่สำหรับการวิเคราะห์เชิงลึกเกี่ยวกับบริบทไทยโดยเฉพาะ การเงิน การลงทุน หรือสถานการณ์ปัจจุบัน โมเดลเหล่านี้ยังไม่ใช่คำตอบสุดท้าย
ผมไม่ได้หมายความว่าโมเดลเหล่านี้ไม่ดี ในทางตรงกันข้าม ผมประทับใจกับพัฒนาการที่รวดเร็วมากในช่วงสองสามปีที่ผ่านมา จากโมเดลที่ไม่เข้าใจภาษาไทยเลย ตอนนี้เป็นโมเดลที่สามารถสื่อสารได้ค่อนข้างดี
แต่เราต้องรู้ขอบเขตของมัน
ทิศทางการทดลองถัดไป
ผมกำลังพิจารณาการทดลอง 3 แนวทาง:
- Fine-tuning โมเดลขนาดกลางด้วยข้อมูลทางการเงินไทย เพื่อเพิ่มความเชี่ยวชาญเฉพาะด้าน
- RAG (Retrieval-Augmented Generation) การใช้ฐานข้อมูลข่าวและรายงานทางการเงินไทยร่วมกับการเรียกใช้โมเดล เพื่อให้โมเดลเข้าถึงข้อมูลล่าสุดได้
- Ensemble approach การรวมผลลัพธ์จากโมเดลหลายตัวเพื่อลดข้อจำกัดของโมเดลแต่ละตัว
ผมจะรายงานผลของการทดลองเหล่านี้ในบทความต่อไป
มุมมองส่วนตัว: ความหวังและความจริง
ผมมีความหวังว่าโมเดล LLM ภาษาไทยจะพัฒนาอย่างรวดเร็วในช่วง 2-3 ปีข้างหน้า โดยเฉพาะเมื่อมีโมเดลเช่น "ปทุมมา" และ "Typhoon" ที่พัฒนาโดยทีมไทยเกิดขึ้น
แต่เราต้องรอด้วยความอดทน และอย่าคาดหวังเกินจริงจากเทคโนโลยีที่ยังอยู่ในช่วงเริ่มต้น
ในระหว่างนั้น การเข้าใจขอบเขตของโมเดล LLM open-source ขนาดกลางจะช่วยให้เราใช้งานได้อย่างมีประสิทธิภาพมากขึ้น และไม่ถูกหลอกด้วยคำตอบที่ดูดีแต่ขาดความแม่นยำ
ผมยังคงตื่นเต้นกับความเป็นไปได้ของ AI ในบ้าน ที่เราสามารถทดลองและเรียนรู้ได้จากประสบการณ์ตรง ไม่ต้องรอให้บริษัทใหญ่พัฒนาเสร็จก่อน
ห้องแล็บ iCafeFX จะยังคงเป็นพื้นที่สำหรับการทดลองเหล่านี้ต่อไป
แหล่งอ้างอิง/ที่มา
- [job#12031] Heartbeat ของระบบ local-ai-models บน redhatai.net แสดงสถานะ LIVE พร้อม JSON-LD markup
- [job#12027] Reconnaissance check ของ router 8788 และระบบ draft generation สำหรับหัวข้อ local-ai-models
- [job#12014] Job handoff สำหรับ cafefx_writer_mvp_phase2 ที่ผ่านการตรวจสอบแล้ว
- [job#12013] การตรวจสอบ writer v7 sha b1744d45 ที่ผ่านทั้ง 7 gates รวมถึง CJK sanitize
- [job#12007] STEP0 check ก่อนการรัน arm-b evaluation
- [job#12005] Launch ของ arm-b evaluation ด้วย 20 articles x 2 models x 3 repetitions
ติดตามการทดลองของแล็บ
ถ้าคุณสนใจติดตามการทดลอง AI ในบ้านของผม สามารถติดตามผ่าน LINE ได้โดยพิมพ์คำว่า LINE เพื่อรับอัปเดตเกี่ยวกับการทดลองใหม่ ผลลัพธ์ และบทเรียนที่ได้จากการทดสอบจริงในแล็บ iCafeFX
หลักฐานจากระบบจริงของเรา
docker ps บนเซิร์ฟเวอร์หลักของแล็บ วันที่ 2026-09-16 (คอนเทนเนอร์ระบบเราจริง)
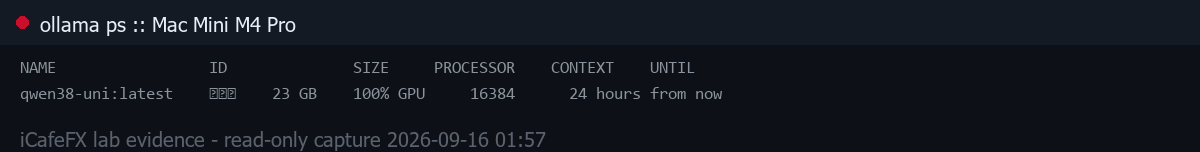
ollama ps บน Mac Mini M4 Pro วันที่ 2026-09-16 (โมเดลที่โหลดอยู่จริง)
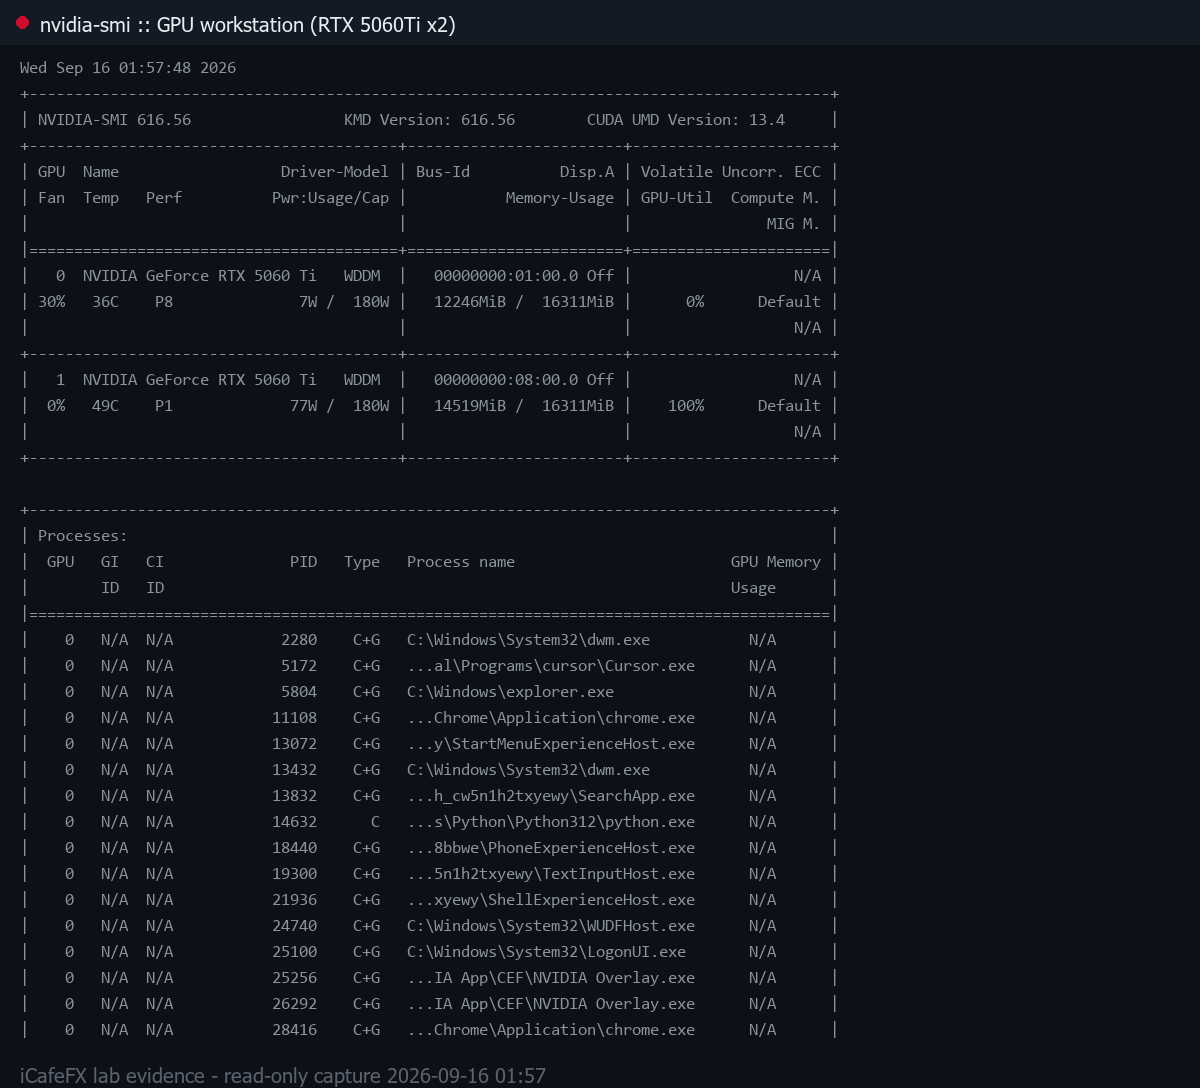
nvidia-smi บนเครื่องเวิร์กสเตชัน (RTX 5060Ti x2) วันที่ 2026-09-16
