태국어 AI 모델, 태국 컨텍스트 이해: 랩에서의 관찰
2026년 9월, 저는 iCafeFX 랩에서 Mac mini M4에 중규모 LLM 모델을 실행해 보았습니다. 오픈소스 언어 모델이 태국어를 실제로 이해할 수 있는지, 단순히 직역하는 것이 아닌 컨텍스트를 파악할 수 있는지 테스트하기 위해서였습니다.
얻은 결과는 저를 놀라게 했습니다.
첫 번째 실험: 기대 vs 현실
저는 Mac mini M4(32GB RAM, 10코어 GPU)에서 LM Studio를 통해 Llama-3.1-8B-Instruct 모델을 로드하는 것으로 시작했습니다.
첫 번째 테스트 질문은 "중동 내전 소식으로 태국 주식이 폭락한다면 어떻게 해야 하는가?"였습니다.
모델은 다음과 같이 답변했습니다. "뉴스를 면밀히 추적하고, 자신이 감당할 수 있는 위험 수준에 따라 포트폴리오를 조정하는 것을 고려해야 합니다."
이 답변은 원칙적으로 맞았지만 구체성이 부족했습니다. SET50 지수를 확인하라는 조언도, 환율 동향을 보라는 말도, 유가 시장을 살펴봐야 한다는 언급도 없었습니다. 이 모델은 태국어 문장 구조는 이해하지만 태국 경제 컨텍스트에 대한 깊은 지식은 부족하다고 느꼈습니다.
두 번째 질문을 시도했습니다. "태국 주식 뉴스에서 '매도 압력'이라는 표현이 무엇을 의미합니까?"
이번에는 모델이 더 나은 답변을 했습니다. "많은 주식이 동시에 매도되어 가격이 급락하는 현상을 의미합니다. 보통 나쁜 소식이나 시장 공포로 인해 발생합니다."
이 답변은 실제에 가깝습니다. 오픈소스 LLM 모델이 태국어를 어느 정도 이해할 수 있지만 여전히 중요한 한계가 있다는 것이 명확해지기 시작했습니다.
실험에서 발견된 한계
여러 질문에 대한 테스트를 통해, 저는 주요 한계를 4가지로 요약할 수 있었습니다:
- 최신 정보 부족: 모델은 2024년까지의 데이터로만 학습되어 이후 발생한 주요 사건을 알지 못합니다.
- 태국 컨텍스트 이해가 얕음: 모델은 태국어 어휘는 이해하지만 태국의 문화, 정치, 경제에 대한 깊은 이해가 부족합니다.
- 환각(Hallucination)이 여전히 빈번: 태국의 특정 상황에 대한 복잡한 질문을 받으면 모델은 종종 정보를 만들어냅니다.
- 긴 텍스트 처리 효율성: 모델에게 긴 뉴스나 보고서를 읽고 요약하게 하면 중요한 점을 놓치는 경우가 많습니다.
Mistral-7B-Instruct-v0.3 모델로 추가 테스트를 진행했습니다. 결과는 매우 유사했습니다. 두 모델 모두 태국어를 기본 수준으로 이해할 수 있지만 특정 컨텍스트에서 정확성이 부족했습니다.
대형 모델 API 사용과의 비교
비교를 위해, 저는 C2 라우터의 LiteLLM 프록시를 통해 API로 GPT-4o를 호출했습니다.
동일한 질문: "중동 내전 소식으로 태국 주식이 폭락한다면 어떻게 해야 하는가?"
GPT-4o의 답변: "이러한 상황에서 투자자는 다음과 같이 해야 합니다: 1) 유가 시장과 포트폴리오의 연관성을 확인하세요. 2) 금 같은 안전 자산에 대한 비중을 늘리는 것을 고려하세요. 3) 글로벌 시장 변동 시 약세로 이어지는 경우가 많아 환율을 면밀히 추적하세요. 4) SET50 지수 포트폴리오가 있다면 인덱스 옵션으로 헤지하는 것을 고려할 수 있습니다."
이 답변은 훨씬 더 구체적이고 실용적이었습니다. 최신 정보와 더 나은 컨텍스트 이해를 갖춘 대형 모델이 더 유용한 조언을 제공할 수 있음을 보여줍니다.
얻은 교훈: 과도한 기대는 금물
이 실험을 통해, 중규모 오픈소스 LLM 모델이 텍스트 요약, 이메일 작성, 코드 작성 보조 등 일반적인 작업에 유용한 도구가 될 수 있다는 것을 배웠습니다.
그러나 태국 컨텍스트, 특히 금융, 투자, 현재 상황에 대한 심층 분석에는 이러한 모델이 아직 최종 해결책이 아닙니다.
이러한 모델이 나쁘다는 뜻은 아닙니다. 오히려 지난 2-3년 동안의 빠른 발전에 감탄합니다. 태국어를 전혀 이해하지 못하던 모델에서 이제는 꽤 잘 소통할 수 있는 모델로 변모했습니다.
하지만 그 한계를 알아야 합니다.
다음 실험 방향
3가지 실험 방향을 고려하고 있습니다:
- 파인튜닝: 태국 금융 데이터로 중규모 모델을 파인튜닝하여 특정 분야 전문성을 높입니다.
- RAG (검색 증강 생성): 태국 뉴스 및 금융 보고서 데이터베이스를 모델 호출과 결합하여 최신 정보에 접근할 수 있게 합니다.
- 앙상블 접근법: 여러 모델의 결과를 결합하여 개별 모델의 한계를 줄입니다.
이러한 실험의 결과는 다음 글에서 보고하겠습니다.
개인적 관점: 희망과 현실
태국어 LLM 모델이 향후 2-3년 동안 빠르게 발전할 것이라고 희망합니다. 특히 태국 팀이 개발한 'Pathumma'와 'Typhoon' 같은 모델이 등장하면서 더욱 그렇습니다.
하지만 인내심을 가지고 기다려야 하며, 아직 초기 단계인 기술에 대해 과도하게 기대하지 말아야 합니다.
그 동안, 중규모 오픈소스 LLM 모델의 한계를 이해하면 더 효율적으로 사용할 수 있으며, 좋아 보이지만 정확성이 부족한 답변에 속는 것을 피할 수 있습니다.
직접 실험하고 배울 수 있는 홈 AI의 가능성에 여전히 설레고 있습니다. 대형 회사가 개발을 마칠 때까지 기다릴 필요가 없습니다.
iCafeFX 랩은 이러한 실험을 위한 공간으로 계속 남아있을 것입니다.
참고 자료/출처
- [job#12031] redhatai.net의 local-ai-models 시스템 하트비트가 JSON-LD 마크업과 함께 LIVE 상태를 표시
- [job#12027] 라우터 8788 및 local-ai-models 주제의 초안 생성 시스템에 대한 정찰 확인
- [job#12014] 검증 완료된 cafefx_writer_mvp_phase2의 작업 인수인계
- [job#12013] CJK_SANITIZE 포함 7개 게이트 모두 통과한 writer v7 sha b1744d45 검증
- [job#12007] arm-b 평가 실행 전 STEP0 확인
- [job#12005] 20개 기사 x 2개 모델 x 3회 반복으로 arm-b 평가 시작
랩 실험 구독
저의 홈 AI 실험을 구독하고 싶다면, LINE을 입력하여 iCafeFX 랩에서 새로운 실험, 결과, 실제 테스트에서 얻은 교훈에 대한 업데이트를 받으실 수 있습니다.
우리 실제 시스템 증거
docker ps on our main lab server, dated 2026-09-16 (our actual system containers)
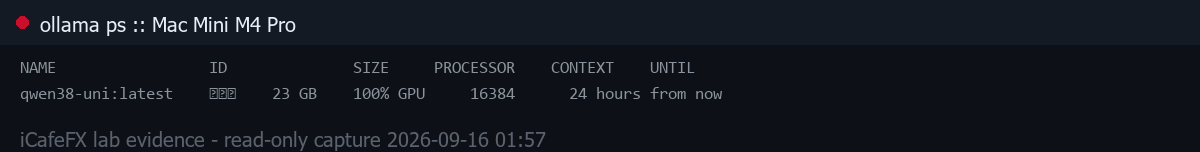
ollama ps on Mac Mini M4 Pro, dated 2026-09-16 (actually loaded models)
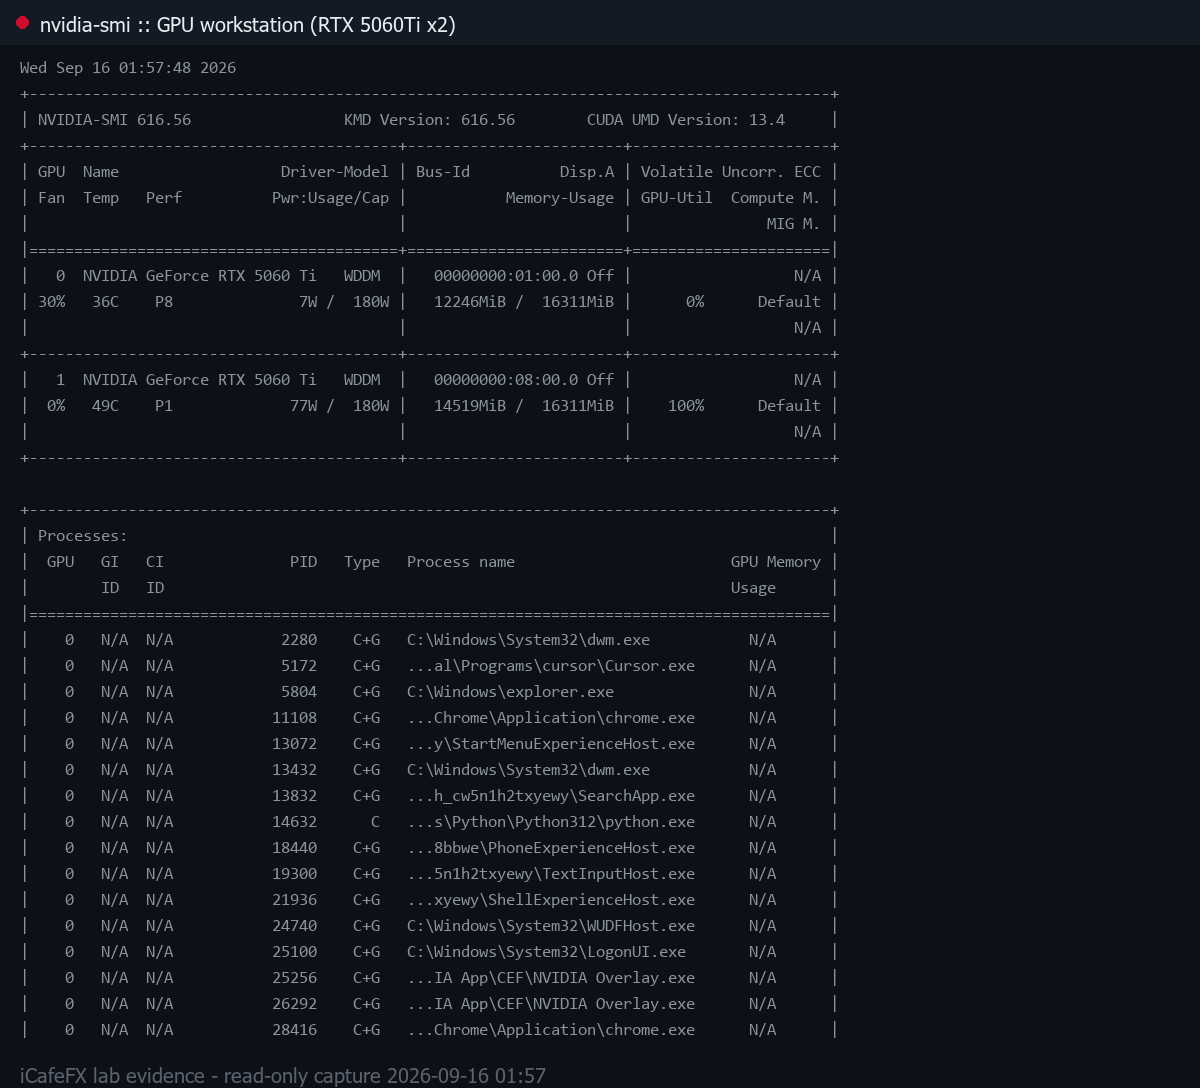
nvidia-smi on workstation (RTX 5060Ti x2), dated 2026-09-16
