今晚我凌晨五点醒来,不是因为噩梦,而是因为两张 16GB 显卡的风扇在高速运转,几乎像是在为我的家庭实验室生活配乐。那嗡嗡声暗示着系统正在全力进行图像生成和大型模型推理。我走到显示服务器、渲染机和私有存储状态的仪表盘前,屏幕上的数字让我既自豪又隐隐不安。
显卡满载之夜概览
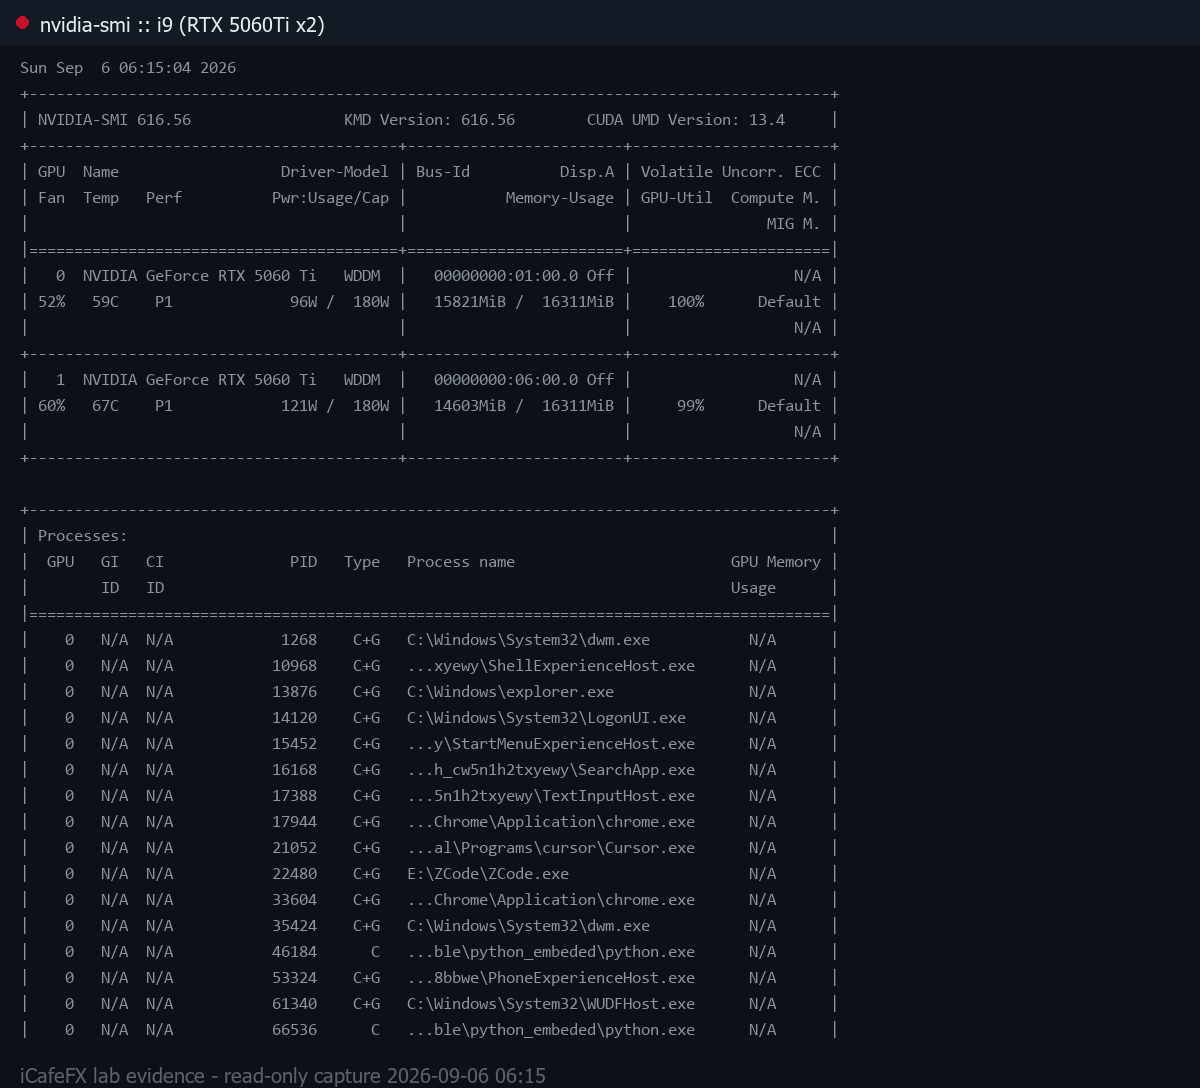
查看使用率图表,第一张显卡利用率达到 100%,显存已用 15,745 MiB / 16,311 MiB,剩余空间极少。第二张显卡也差不多,利用率 98%,显存 14,475 MiB。这些数字可不是闹着玩的,意味着系统已经接近物理极限。我看到 ComfyUI 的任务队列中,FLUX 模型和 qwen_image_edit 正在同时运行——平时我们不会这么做,怕系统崩溃,但今晚我决定试试把机器推到满负荷会怎样。
两张显卡显存都接近 16GB 满载,这是一个无声的警报。我经历过太多次 OOM(内存溢出)问题,几乎要放弃。系统还能撑住不崩溃,说明我们设计的架构开始变得稳定了。但每当屏幕上的数字闪烁时,担忧就挥之不去。这就像在湿滑路面上超速行驶——你知道危险,却忍不住想测试轮胎和刹车的极限。
任务队列与出图节奏
让我不得不起来查看的原因是出图速度——大约每小时 10 张,对于这个级别的家庭实验室来说相当高。我查看连接到 ComfyUI 的 n8n 任务队列,发现 job #9403 正在 M3-M6 阶段运行,包括 seed、prompt 和各种 gates。之前的 #9402 和 #9401 都已通过 VERIFIED 状态,说明我们的流水线运转顺畅。
图像源源不断地生成而不卡顿,这值得称赞。但队列中"同时"这个词让我担忧。同时运行 FLUX 和 qwen_image_edit 导致 GPU 频繁切换上下文,长期来看可能影响整体性能。我注意到虽然出图量大,但部分图像质量略显不稳定,这是资源密集共享的副作用。
GPU 定律与 Borrow/TTL 机制的启示
在观察系统运行的过程中,我想到了我为这个家庭实验室制定的"GPU 定律",强调动态资源管理。为各种任务设置 borrow(借用)和 TTL(生存时间)机制至关重要,因为没有这些机制,某些任务可能会长时间占用 GPU,导致其他任务等待甚至失败。
今晚我清楚地看到了 TTL 的价值。当一个任务完成后,它会立即释放资源回资源池,让下一个任务无需长时间等待即可使用。borrow 机制让我们可以在需要时临时从其他部分借用资源,从而提高吞吐量。但风险在于,如果借用出错,系统可能进入死锁状态。所以我必须密切检查日志,看是否有异常的等待情况。
失败与自主交易的教训
除了技术问题,今晚我对自主交易的结果也感到沮丧。表现不如预期平稳,让我决定拆分出一个小交易账户来降低风险。但在家庭实验室方面,我发现试图亲自控制一切的风险很高。GPU 长时间 100% 运行可能导致热量积累,影响长期使用寿命。
重要教训是:"不要强迫系统超出其承受能力。"即使数字看起来很漂亮,机器的健康也比短期吞吐量更重要。我认识到好的系统设计必须有足够的灵活性,在必要时能够停止或减速,而不是一味追求最快。今晚的小小失败让我看到监控流程的弱点——缺乏足够清晰的告警机制。
下一步计划与熬过忙碌之夜后的感受
守到清晨后,我决定将 ComfyUI 的并发量减半,以换取稳定性和 GPU 寿命。愿意牺牲一些速度来换取可持续性,这是家庭实验室工程师必须学会的。我将增加更严格的热节流机制,并检查 Mac Mini M4 Pro 上 qwen38-chat:latest 的日志——它同样在以 32768 tokens 的上下文高强度运行。
今晚教会我,运营家庭 AI 实验室不仅仅是积累设备,更是理解并尊重其限制。我为系统还能撑住而感到自豪,但也意识到还有大量改进空间,才能让这个家庭实验室长期可持续运行,而不必每晚都起来守着。
!来自私有存储服务器的 docker ps 截图,2026-09-06,我们的真实系统容器
!来自我们渲染机的 nvidia-smi 截图,2026-09-06,所有显卡几乎满载