今夜は5時に目が覚めた。悪夢ではなく、両方の16GB GPUのファンが私のhomelab生活に寄り添うかのように激しく鳴っていたからだ。その唸り声は、システムが画像生成と大規模モデルの処理を同時にこなしていることを示していた。ダッシュボードの画面を見に行くと、マシン、レンダラー、そして個人用ストレージサーバーの状態が表示されていた。そこに現れた数字は、私に誇りと不安を同時に抱かせた。
GPUが過負荷で動いた夜の概要
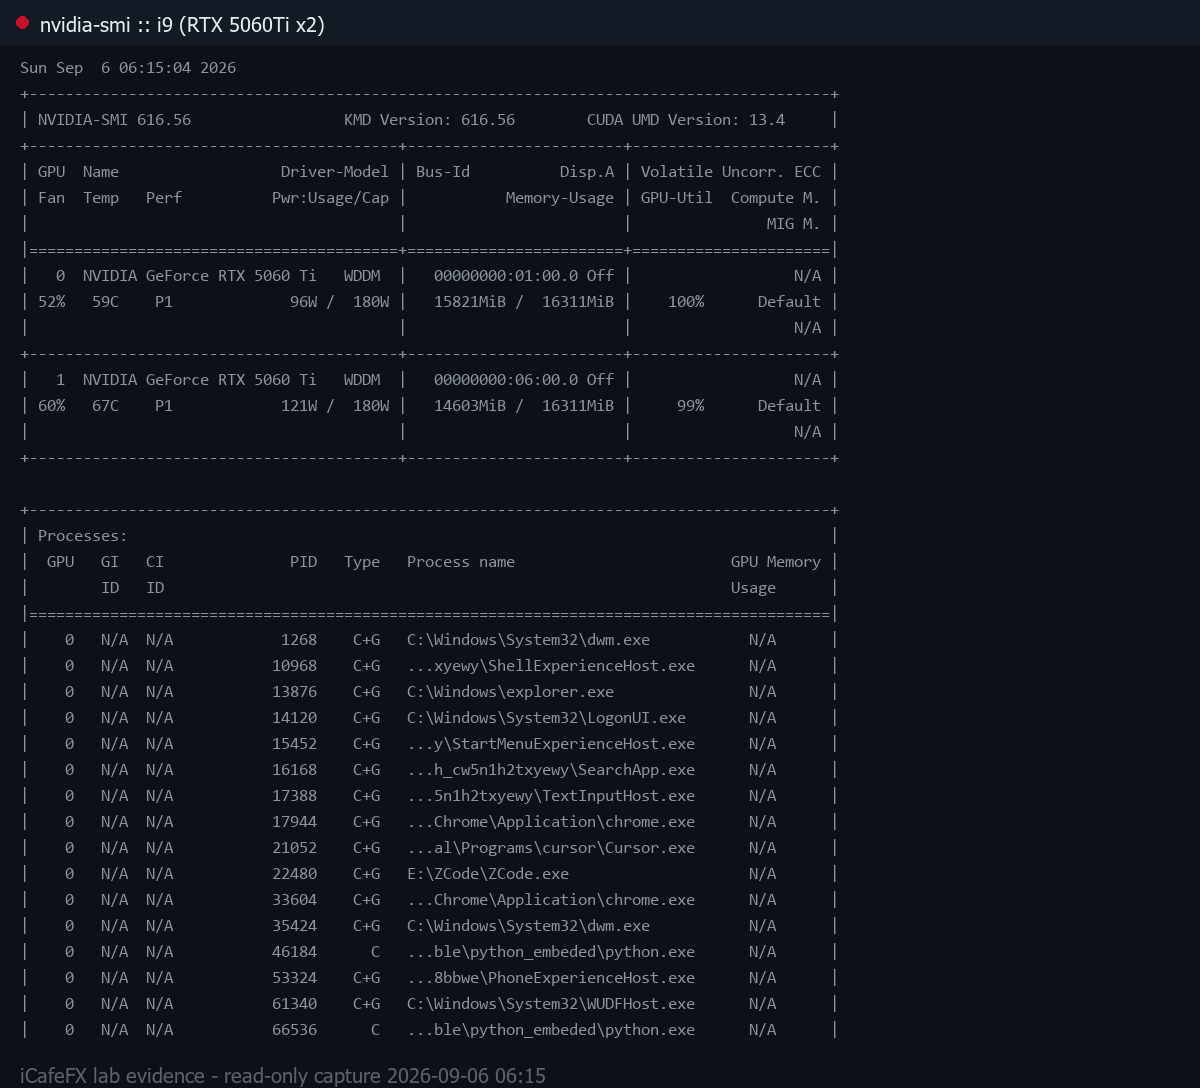
利用状況グラフを見ると、最初のGPUはUtilization 100%でフル稼働し、メモリは16,311 MiB中15,745 MiBを使用しており、ほとんど余裕がなかった。2番目のGPUも98%でメモリ14,475 MiBとほぼ同様の状況だった。これらの数字は冗談ではない。システムが物理的な限界に近づいてまで過負荷で動いていることを意味していた。ComfyUIのキューを見ると、FLUXモデルとqwen_image_editが同時に実行されていた。通常はシステムがクラッシュするのを恐れてこのようなことはしないが、今夜は全力で稼働させた場合の結果を試してみることにした。
両方のGPUでほぼ16GBのメモリが使用されていることは、静かな警告信号だった。OOM(Out of Memory)の問題に何度も遭遇し、ほとんど諦めかけた経験がある。システムがクラッシュせずに持ちこたえていることは、私たちが設計したアーキテクチャが少し安定してきたことを示している。しかし、画面上で数字が点滅するたびに不安は続いていた。濡れた路面で速度制限を超えて運転するようなものだ。危険だと知りながら、タイヤとブレーキの限界を試したくなる。
ジョブキューと画像生成のリズム
私が目を覚まして確認したかったのは、1時間あたり約10枚という画像生成レートだった。このレベルのホームラボとしては非常に高いレートである。ComfyUIに接続されたn8nのジョブキューを見ると、job #9403がM3-M6フェーズ(seed、prompt、各種gatesを含む)で実行中だった。それ以前の#9402や#9401はすべてVERIFIED状態を通過しており、私たちのパイプラインが継続的に動作していることを示していた。
画像が途切れることなく生成され続けるのは賞賛に値するが、キュー内の「同時」という言葉に私は不安を感じた。FLUXとqwen_image_editを同時に実行することで、GPUは頻繁にコンテキストを切り替える必要があり、長期的には全体のパフォーマンスに影響を与える可能性がある。画像の数は多く出ているものの、いくつかの品質にわずかな不安定さが見られ、これはリソースが密集して共有されていることによる副作用だった。
GPU LawとBorrow/TTLの概念から学んだこと
システムが動作するのを観察しながら、私はこのホームラボのために定めた「GPU Law」の原則について考えた。それはリソースの動的な管理に重点を置いている。ジョブに対してborrowとTTL(Time To Live)のシステムを持つことは非常に重要だ。なぜならこのメカニズムがなければ、あるジョブがGPUを長すぎる時間占有し、他のジョブが待たされたり失敗したりする可能性があるからだ。
今夜、TTLの価値を明確に認識した。あるジョブが完了すると、リソースはすぐにプールに戻され、次のジョブが長い待ち時間なしで使用できるようになる。borrowシステムにより、必要に応じて他の部分からリソースを一時的に借りることができ、throughputを高めることができる。しかしリスクは、その借用が誤るとシステムがデッドロック状態に陥る可能性があることだ。そのため、異常な待ちが発生していないかlogを注意深く確認する必要がある。
失敗と自分でトレードして学んだこと
技術的なこと以外にも、今夜は自分でトレードした結果に失望した。期待していたほど安定した結果ではなかったため、リスクを減らすために小さなトレードポートを分離することを決めた。しかしhomelabの観点からは、すべてを自分で制御しようとする試みは非常にリスクが高いことを発見した。GPUが100%で長すぎる時間稼働すると熱が蓄積し、長期的な寿命に影響を与える可能性がある。
重要な教訓は「システムが耐えられる範囲を超えて無理をしないこと」だ。数字が立派に見えても、機械の健康状態は一時的なthroughputよりも重要である。良いシステム設計は、必要に応じて停止または減速できるだけの柔軟性を持たねばならず、常に最速に押し進めるだけではない。今夜の小さな失敗は、監視プロセスにまだ明確なアラートが不足している弱点を明らかにした。
次の計画と過酷な夜を過ごしてからの感想
朝まで監視した後、ComfyUIのconcurrencyを半分にする決定を下した。GPUの安定性と寿命との交換だ。持続可能性のために多少の速度を犠牲にすることは、ホームラボエンジニアが学ぶべきことだ。より厳格なサーマルスロットリングシステムを追加し、Mac Mini M4 Pro上のqwen38-chat:latestのlogも確認する。これも32768トークンのコンテキストで過負荷で動いているからだ。
今夜は、家庭のAIラボであることは単に機器を収集することではなく、限界を理解しそれを尊重することであることを教えてくれた。システムがまだ持ちこたえていることに誇りを感じると同時に、このhomelabが長期的に持続可能に動作できるよう、まだ多くの改善が必要だと認識した。毎晩こうして目を覚まして監視する必要のないように。
!2026-09-06の個人用ストレージサーバーからのdocker ps画面。実際のシステムコンテナ
!2026-09-06の私たちのレンダラーからのnvidia-smi画面。すべてのカードがほぼフル稼働