오늘 밤 저는 악몽이 아니라 두 개의 16GB GPU 팬 소리에 의해 새벽 5시에 깨어났습니다. 그 굉음은 제 홈랩의 삶을 배경으로 노래하는 것 같았으며, 시스템이 이미지 생성과 대규모 모델 처리를 동시에 수행하고 있다는 것을 암시했습니다. 저는 머신 상태, 렌더링 머신, 개인 스토리지 노드를 표시하는 대시보드를 보러 나왔습니다. 나타나는 숫자들은 저에게 동시에 자부심과 불안감을 주었습니다.
GPU가 무리하게 작동한 밤의 개요
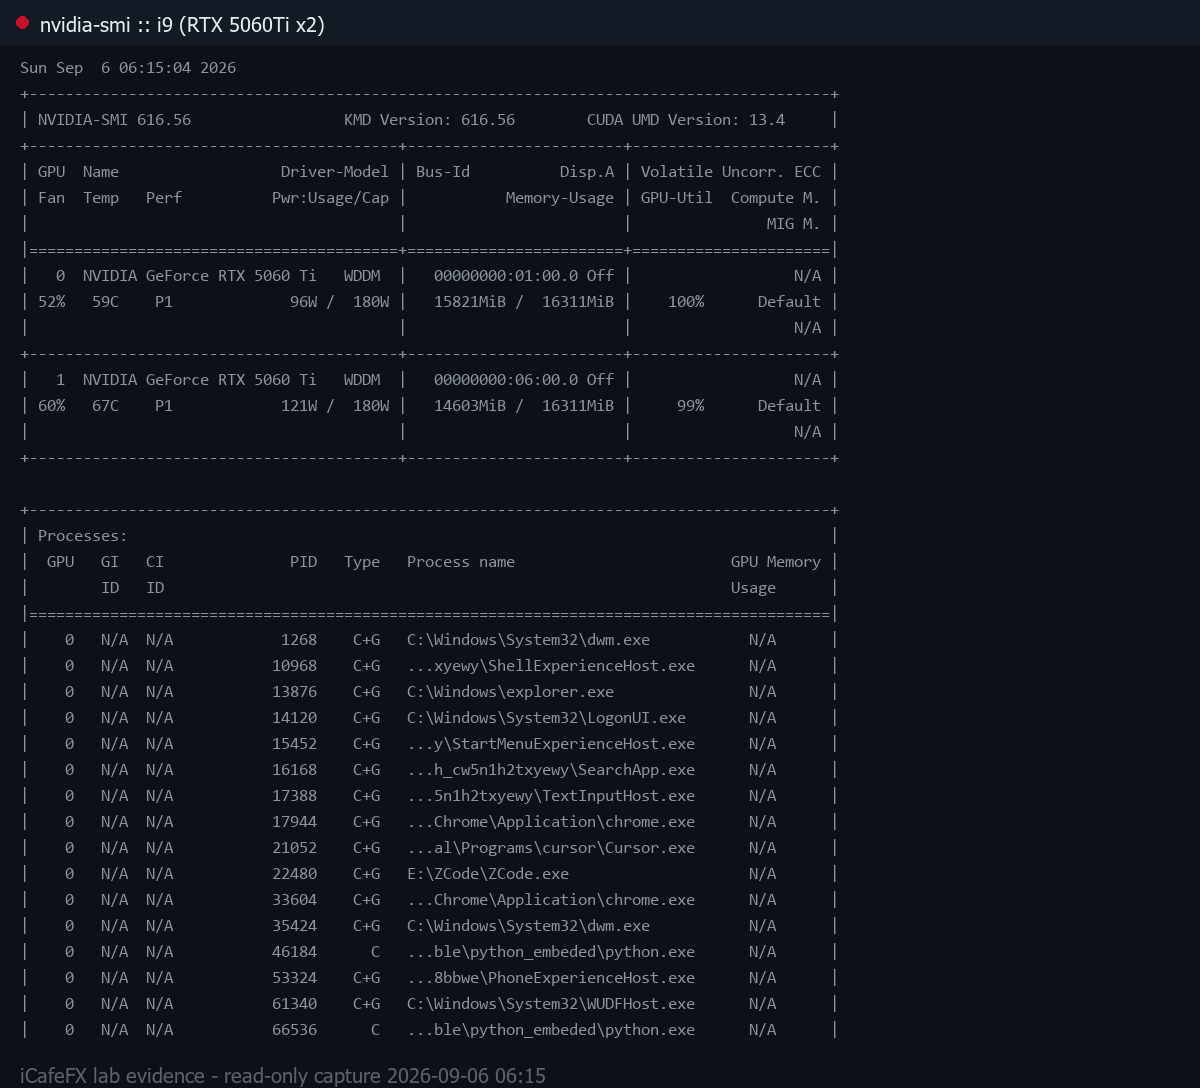
사용량 그래프를 보면 첫 번째 GPU는 100%의 사용률을 보였으며, 메모리는 총 16,311 MiB 중 15,745 MiB가 사용되어 호흡할 여지가 거의 없었습니다. 두 번째 카드도 98%와 14,475 MiB의 메모리로 유사했습니다. 이러한 숫자들은 장난이 아닙니다. 시스템이 물리적 한계에 거의 도달할 정도로 무리하게 작동하고 있다는 것을 의미합니다. 저는 ComfyUI에서 FLUX 모델과 qwen_image_edit를 동시에 실행하는 작업 큐를 보았습니다. 일반적으로 시스템이 다운될까 봐 이런 일은 하지 않지만, 오늘 밤 저는 그것이 전체적인 잠재력을 발휘했을 때 결과가 어떻게 될지 시험해 보기로 결정했습니다.
두 카드 모두 거의 16GB의 메모리가 사용된 것은 조용한 경고 신호였습니다. 저는 OOM(Out of Memory) 문제를 여러 번 겪어 거의 포기할 뻔했습니다. 시스템이 크래시 없이 견뎌내고 있다는 것은 우리가 설계한 아키텍처가 조금 더 안정적이 되어 가고 있음을 보여줍니다. 그러나 화면에 숫자가 깜빡이는 모든 순간에 우려는 여전히 존재합니다. 젖은 도로에서 속도 제한을 초과하여 운전하는 것과 같습니다. 위험하다는 것을 알지만 타이어와 브레이크 시스템의 한계를 테스트하고 싶어합니다.
작업 큐와 이미지 생성 리듬
저를 깨어나게 만든 것은 시간당 약 10장의 이미지 생성 속도였습니다. 이 수준의 홈랩에서는 매우 높은 비율로 간주됩니다. ComfyUI에 연결된 n8n의 작업 큐를 살펴보니 job #9403이 seed, prompt 및 다양한 gates를 포함하는 M3-M6 단계에서 실행 중이었습니다. 이전 작업인 #9402와 #9401은 모두 VERIFIED 상태를 통과했습니다. 이는 우리의 파이프라인이 연속적으로 작동하고 있음을 보여줍니다.
이미지가 막힘 없이 계속 생성되는 것은 칭찬할 만한 일입니다. 그러나 작업 큐의 "동시"라는 단어에 대해 우려를 느꼈습니다. FLUX와 qwen_image_edit를 동시에 실행하면 GPU가 자주 컨텍스트를 전환해야 하며, 이는 장기적으로 전체 성능에 영향을 미칠 수 있습니다. 이미지 수가 많았지만 일부는 약간 불안정한 품질을 보였는데, 이는 자원이 밀집되게 공유된 결과였습니다.
GPU Law와 Borrow/TTL 개념에서의 교훈
시스템이 작동하는 것을 지켜보면서 저는 이 홈랩을 위해 세운 "GPU Law" 원칙을 생각했습니다. 이는 동적 자원 관리에 중점을 둡니다. 다양한 작업에 대한 borrow 및 TTL(Time To Live) 시스템을 갖는 것은 매우 중요합니다. 왜냐하면 이 메커니즘이 없다면 일부 작업이 GPU를 너무 오래 점유하여 다른 작업들이 대기하거나 실패할 수 있기 때문입니다.
오늘 밤 저는 TTL의 가치를 명확하게 보았습니다. 하나의 작업이 완료되면 자원을 즉시 풀로 반환하여 다음 작업이 오래 기다리지 않고 계속 사용할 수 있게 합니다. borrow 시스템은 필요할 때 다른 부분에서 자원을 일시적으로 빌릴 수 있게 하여 throughput을 높일 수 있습니다. 그러나 위험은 빌리기가 잘못되면 시스템이 데드락 상태에 빠질 수 있다는 것입니다. 따라서 저는 비정상적인 대기를 확인하기 위해 로그를 면밀히 모니터링해야 합니다.
실패와 직접 트레이딩에서 배운 것들
기술적인 문제 외에도 오늘 밤 저는 직접 트레이딩의 성과에 대해 실망했습니다. 결과는 기대했던만큼 안정적이지 않았습니다. 그래서 저는 위험을 줄이기 위해 작은 트레이딩 포트폴리오를 분리하기로 결정했습니다. 그러나 홈랩 측면에서는 모든 것을 스스로 통제하려는 시도가 매우 높은 위험을 수반한다는 것을 발견했습니다. GPU가 100%로 너무 오래 작동하면 열이 축적되어 장기적으로 수명에 영향을 미칠 수 있습니다.
중요한 교훈은 "시스템이 감당할 수 있는 한계를 넘어서지 마라"입니다. 숫자가 멋져 보일지라도 기계의 건강이 일시적인 throughput보다 중요합니다. 저는 좋은 시스템 설계가 필요할 때 멈추거나 늦출 수 있을 만큼 유연해야 하며, 항상 가장 빠르게 밀어붙이는 것이 아니어야 한다는 것을 배웠습니다. 오늘 밤의 작은 실패들은 모니터링 프로세스에서 명확한 알림이 부족한 약점을 보여주었습니다.
다음 계획과 무거운 밤을 지나고 난 후의 느낌
아침까지 지켜본 후 저는 ComfyUI의 동시성을 절반으로 줄이기로 결정했습니다. GPU의 안정성과 수명을 위해 속도를 일부 희생하는 것입니다. 지속가능성을 위해 속도를 일부 포기하는 것은 홈랩 엔지니어가 배워야 할 것입니다. 저는 더 엄격한 열 스로틀링 시스템을 추가하고, 32768 토큰의 컨텍스트로 열심히 작동하는 Mac Mini M4 Pro에서 qwen38-chat:latest의 로그를 확인하겠습니다.
오늘 밤은 저에게 가정용 AI 랩이 단순히 장비를 수집하는 것이 아니라 한계를 이해하고 존중하는 것임을 가르쳐 주었습니다. 시스템이 아직 견뎌내고 있다는 것에 자부심을 느꼈지만, 이 홈랩이 매번 이렇게 깨어나서 지켜보지 않고도 장기적으로 지속 가능하게 작동할 수 있도록 많은 개선이 필요하다는 것도 깨달았습니다.
!2026-09-06 개인 스토리지 노드의 실제 docker ps 화면
!2026-09-06 우리 렌더링 머신의 nvidia-smi 화면, 모든 카드가 거의满载