Đêm nay tôi thức dậy lúc năm giờ sáng, không phải vì ác mộng mà vì tiếng quạt của hai card đồ họa 16GB hoạt động hết công suất đến mức gần như hát thành bài cho cuộc sống homelab của tôi. Tiếng ù ù ấy báo hiệu hệ thống đang đốt cháy sức mạnh xử lý để tạo hình ảnh và chạy các mô hình lớn cùng lúc. Tôi bước ra xem màn hình dashboard hiển thị trạng thái máy chủ, máy render và máy lưu trữ dữ liệu cá nhân. Những con số hiện ra khiến tôi vừa tự hào vừa lo lắng trong cùng một lúc.
Tổng quan đêm GPU hoạt động hết công suất
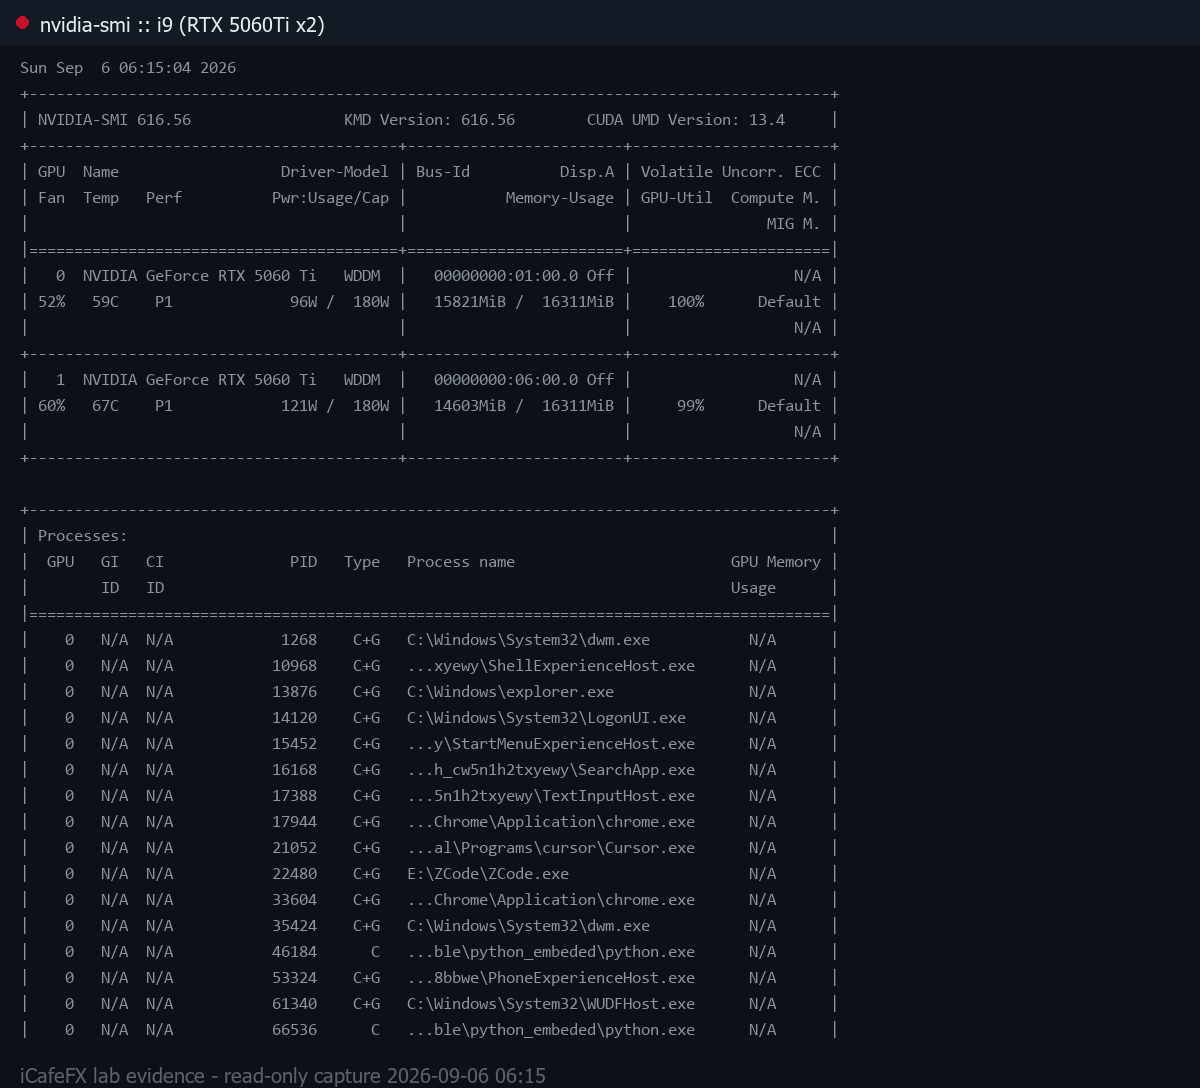
Khi nhìn vào biểu đồ sử dụng, card đồ họa đầu tiên có Utilization 100% hoàn toàn, trong khi bộ nhớ đã sử dụng 15.745 MiB trên tổng 16.311 MiB, chỉ còn rất ít không gian để thở. Card thứ hai cũng tương tự với 98% và bộ nhớ 14.475 MiB. Những con số này không phải là trò đùa - nó có nghĩa hệ thống đang hoạt động gần đến giới hạn vật lý. Tôi thấy hàng đợi công việc trong ComfyUI đang chạy mô hình FLUX cùng lúc với qwen_image_edit, điều mà bình thường chúng tôi không làm vì sợ hệ thống sập. Nhưng đêm nay tôi quyết định thử xem nếu ép nó hoạt động hết khả năng thì kết quả sẽ ra sao.
Việc bộ nhớ gần như 16GB trên cả hai card đều được sử dụng là một tín hiệu cảnh báo im lặng. Tôi đã gặp vấn đề OOM (Out of Memory) nhiều lần đến mức suýt bỏ cuộc. Việc hệ thống vẫn đứng vững mà không crash cho thấy kiến trúc chúng tôi thiết kế đang bắt đầu ổn định hơn. Nhưng sự lo lắng vẫn hiện diện mỗi giây khi những con số nhấp nháy trên màn hình. Nó giống như lái xe vượt tốc độ trên đường ướt - bạn biết nó nguy hiểm nhưng vẫn muốn thử giới hạn của lốp và hệ thống phanh.
Hàng đợi công việc và nhịp độ render ảnh
Điều khiến tôi phải thức dậy xem là tốc độ render khoảng 10 ảnh/giờ, mức được coi là rất cao cho homelab ở quy mô này. Tôi xem hàng đợi công việc trong n8n kết nối với ComfyUI, thấy job #9403 đang chạy ở bước M3-M6, bao gồm seed, prompt và các gates khác nhau. Các job trước đó như #9402 và #9401 đều đã qua trạng thái VERIFIED, cho thấy pipeline của chúng tôi hoạt động liên tục.
Việc ảnh được tạo ra liên tục mà không bị gián đoạn là điều đáng khen ngợi, nhưng tôi lại lo lắng về từ "cùng lúc" trong hàng đợi công việc. Việc chạy FLUX và qwen_image_edit đồng thời buộc GPU phải chuyển ngữ cảnh thường xuyên, điều này có thể ảnh hưởng đến hiệu suất tổng thể về dài hạn. Tôi nhận thấy mặc dù số lượng ảnh tạo ra nhiều, nhưng chất lượng một số tấm có vẻ hơi không ổn định - đó là tác dụng phụ của việc tài nguyên được chia sẻ dày đặc.
Bài học từ GPU Law và khái niệm Borrow/TTL
Trong khi quan sát hệ thống hoạt động, tôi nghĩ đến nguyên tắc "GPU Law" mà tôi đã đặt ra cho homelab này, nhấn mạnh việc quản lý tài nguyên động. Có hệ thống borrow và TTL (Time To Live) cho các job khác nhau là rất quan trọng, vì nếu không có cơ chế này, một số job có thể chiếm GPU quá lâu khiến job khác phải chờ đợi hoặc thất bại.
Đêm nay tôi thấy rõ giá trị của TTL. Khi một job hoàn thành, nó sẽ trả tài nguyên trở lại pool ngay lập tức, cho phép job tiếp theo sử dụng mà không phải chờ đợi lâu. Hệ thống borrow giúp chúng tôi có thể tạm thời mượn tài nguyên từ phần khác khi cần thiết, điều này có thể tăng throughput. Nhưng rủi ro là nếu việc mượn đó sai lầm, hệ thống có thể rơi vào trạng thái deadlock. Vì vậy tôi phải kiểm tra log chặt chẽ để xem có sự chờ đợi bất thường nào không.
Thất bại và điều học được từ việc tự trade
Ngoài vấn đề kỹ thuật, đêm nay tôi còn cảm thấy nản lòng với kết quả từ việc tự trade. Kết quả không ổn định như mong đợi, khiến tôi quyết định tách ra một port trade nhỏ để giảm rủi ro. Nhưng về mặt homelab, tôi lại phát hiện nỗ lực kiểm soát mọi thứ bằng tay có rủi ro rất cao. Việc GPU chạy 100% quá lâu có thể gây tích tụ nhiệt và ảnh hưởng đến tuổi thọ dài hạn.
Bài học quan trọng là "đừng ép hệ thống vượt quá khả năng chịu đựng của nó". Dù con số có vẻ đẹp đẽ, sức khỏe của máy móc quan trọng hơn throughput tạm thời. Tôi học được rằng thiết kế hệ thống tốt phải đủ linh hoạt để dừng lại hoặc làm chậm khi cần thiết, không chỉ luôn đẩy nhanh nhất có thể. Những thất bại nhỏ trong đêm nay khiến tôi thấy điểm yếu trong quy trình monitoring, nơi vẫn thiếu alerting đủ rõ ràng.
Kế hoạch tiếp theo và cảm xúc sau đêm dài căng thẳng
Sau khi quan sát đến sáng, tôi quyết định giảm concurrency của ComfyUI xuống một nửa để đổi lấy sự ổn định và tuổi thọ GPU. Chấp nhận hy sinh tốc độ để đổi lấy tính bền vững là điều kỹ sư homelab phải học. Tôi sẽ thêm hệ thống thermal throttling nghiêm ngặt hơn và kiểm tra log của qwen38-chat:latest trên Mac Mini M4 Pro, cũng đang hoạt động nặng với context 32768 tokens.
Đêm nay dạy tôi rằng việc vận hành một phòng lab AI tại nhà không chỉ là tích lũy thiết bị, mà là hiểu và tôn trọng giới hạn của chúng. Tôi tự hào hệ thống vẫn đứng vững, nhưng cũng nhận ra cần cải thiện rất nhiều để homelab này có thể hoạt động bền vững về dài hạn mà không phải thức dậy canh giữ mỗi đêm như vậy.
!Màn hình docker ps từ máy lưu trữ cá nhân, ngày 2026-09-06, container hệ thống thật của chúng tôi
!Màn hình nvidia-smi từ máy render của chúng tôi, ngày 2026-09-06, card chạy gần hết công suất tất cả