今天早上我不是被闹钟叫醒的,而是被系统任务队列在 Docker Hub 泪眼朦胧的屏幕上滚动时发出的通知声吵醒的。
当 127,680 个数据点告诉我们某些东西已经改变
我刚刚在凌晨完成了 Qdrant 到 1.19.1 版本的升级。这不仅仅是一次普通的更新,而是一场对我们整个向量数据库健康状态产生深远影响的大手术。屏幕上显示 healthz 和 readyz 都返回了 200 状态码,意味着系统已完全就绪。但让我瞬间屏住呼吸的是,所有 12 个集合全部完整无缺,累计数据量达到了 127,680 个数据点——对于我们这个小型家庭实验室来说,这是一个相当庞大的数字。
这次升级不仅仅是版本号的变更,更是对我们作为备份方案保存的 4.2 GB Snapshot 完整性的全面验证。我必须确保日志或数据结构中没有任何错误,因为哪怕只有一点点损坏,未来的数据检索都可能给出完全偏离的结果。这一切都发生在短短的时间内,但压力之大足以让我额头渗出冷汗。
两套 Docker Compose 让我头痛到只能坐着喝咖啡
让这次升级不太顺利的主要问题,是如何管理运行在两套不同 Docker Compose 下的 5 个容器。我曾以为我们的系统设计得足够好,能够自我协调,但现实是,当主要版本发生变化时,各服务之间的跨套依赖很容易引发竞态条件。
我不得不暂时停止所有服务,以防止端口和挂载卷之间的冲突。这并非技术上难以解决的问题,而是需要高度谨慎的操作。我把大部分时间花在了检查过渡期间的日志上,看是否有任何错误,特别是 SearXNG 2026.9.5-c7f3080aa 版本与 Qdrant 紧密协作的部分。所有任务顺利通过 q1 到 q4 关卡且没有任何错误警报,这让我如释重负。
从过热 GPU 和沉重模型中汲取的教训
当后台系统正在运行 Hub #9403(自 05:48 起一直处于 RUNNING 状态)时,我密切观察了 Mac Mini M4 Pro 的资源使用情况。25 GB 的 qwen38-chat:latest 模型占用了 GPU 100% 的算力,上下文窗口长达 32,768 个 Token;而另一侧的 qwen2.5vl:7b 模型同样满载运行,也是 100%。
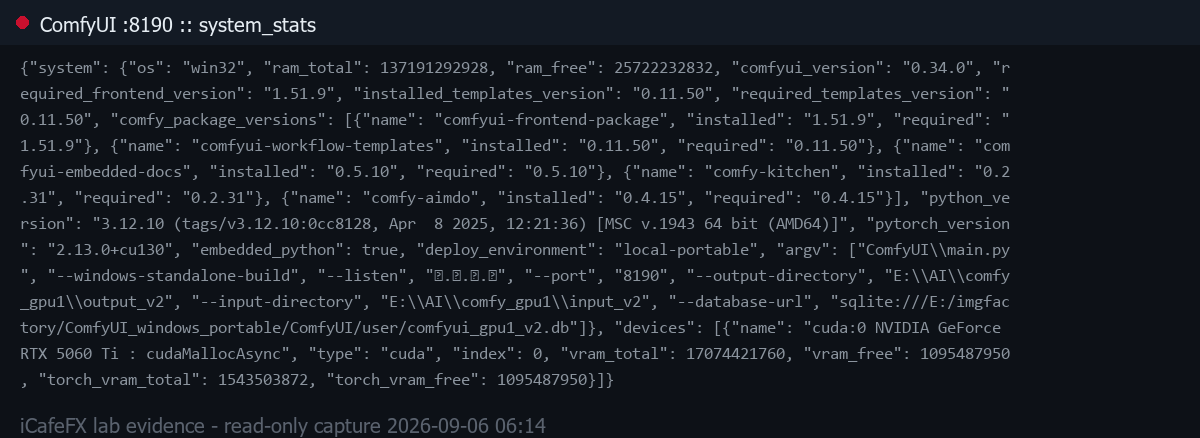
让我停下来思考的是如此高的热量和工作负载。尽管这是一台高性能机器,但长期同时运行两个这样的大型模型可能会影响硬件的使用寿命。我承认,有时我们可能过于急切地将任务推入系统,而没有充分考虑足够的负载均衡。其他渲染机上 16GB 显卡的显存使用率达到 98-100%(15745/16311 MiB 和 14475/16311 MiB),这也是一个警示信号,提醒我们需要更多地考虑负载分布,而不是简单地不断增加硬件。
结束工作前的最后检查与下一步计划
在结束今天的工作之前,我检查了最近一次修改于 2026-09-05 的 Cron 系统,看是否有任何变更会影响当前的工作流程。特别是 icafeforex 晚间时段的内容队列,由于交易结果本身还不够稳定,必须让 Publisher copy trade 失败。因此我需要分离出一个小型交易端口来测试系统的稳定性。
在 selftest 队列的 root_fix_d1_gate 部分做出"Hold"的决定,是一个很好的例子,说明有时我们不应该强迫自己一次性完成所有事情。等待系统更加稳定,而不是匆忙提交可能隐藏 Bug 的工作,是我今天学到的重要教训。我不把升级成功视为终点,而是视为一个需要密切监控的观察期的起点。
运行完一切之后的感受
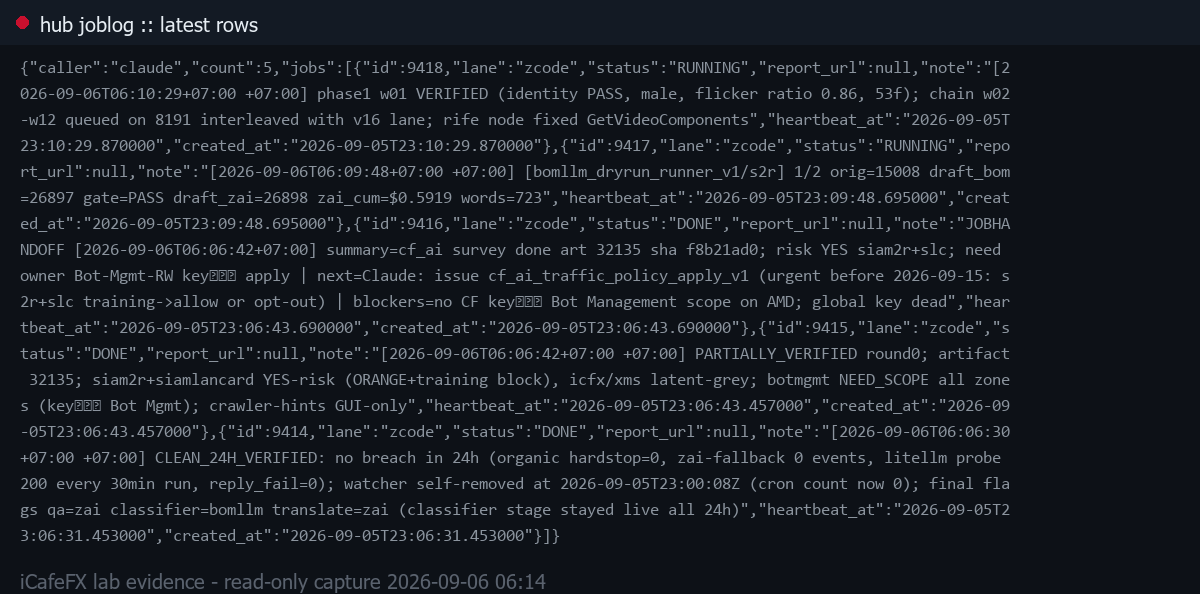
现在我感觉就像刚跑完一场马拉松。尽管 Hub #9401 和 #9402 已经显示 VERIFIED 状态,但心中总有一丝小小的担忧:那个 4.2 GB 的 Snapshot 是否能永远安全?拥有家庭 AI 实验室并不意味着每天都能玩新东西,而是学会与快速变化的技术不确定性共存。
我计划今天下午编写一个更详细的 GPU 内存使用监控脚本,以防止未来再次发生 OOM(内存溢出)。因为从 127,680 个数据点中丢失哪怕一个数据点,都可能意味着失去多年来积累的重要上下文。承认我们会犯错,并学会提前预防,这就是让这个实验室能够持续健康运行的关键。
!渲染机上 ComfyUI 系统状态,2026-09-06,通过 curl 实际获取
!我们工作记录系统中的最新任务行,2026-09-06