今朝は目覚ましで起きたのではなく、Docker Hubの泣きそうな画面を流れるシステムジョブキューの通知音で目が覚めました。
127,680という数字が何か変化があったことを教えてくれた
今朝、Qdrantをバージョン1.19.1にアップグレードしたばかりだ。これは通常のアップデートではなく、私たちのベクトルデータベース全体の健全性に影響を与える大手術だった。画面に表示されたのはhealthzとreadyzがステータス200で応答し、システムが完全に稼働準備ができていることを意味する数字だった。しかし、一瞬息をのんだのは、12中12のコレクションがすべて揃っていること、そして合計127,680ポイントのデータが蓄積されているという事実だった。私たちの小さなホームラボにとって、これは非常に大きな数字だ。
今回のアップグレードは単なるバージョン変更ではなく、バックアップとして保管している4.2GBのスナップショットの完全性を検証するものでもあった。ロゴやデータ構造の部分にエラーが1つでもないことを確認する必要があった。なぜなら、わずかな損傷があっても将来のデータ検索が完全に歪んだ結果を返す可能性があるからだ。すべては短い時間内に起こったが、その圧力は額に汗を滲ませるほどだった。
頭痛がしてコーヒーを啜らざるを得なかった2つのDocker Composeセット
今回のアップグレードがスムーズでなかった主な問題は、異なる2つのDocker Composeセットの下で動作する5つのコンテナを管理することだった。私たちのシステムは自分自身を管理できるほどよく設計されていると思っていたが、実際にはメジャーバージョンの切り替え時に、サービス間のクロスセット依存関係がレースコンディションを引き起こしやすくなるのだ。
ポートとマウントされたボリュームの競合を防ぐために、すべてのサービスを一時停止する必要があった。これは技術的に複雑で能力を超えたものではなく、高い注意が必要だったという問題だ。私は移行期間中にエラーが発生していないかログをチェックすることに多くの時間を費やした。特にQdrantと密接に連携して動作する必要があるSearXNGバージョン2026.9.5-c7f3080aaの部分についてだ。すべてがq1からq4までのゲートをエラー通知なしで通過できたことは、最も安心させられたことだった。
過熱するGPUと重たいモデルからの教訓
バックエンドシステムが05:48からRUNNING状態のHub #9403ジョブを実行している間に、Mac Mini M4 Proのリソース使用状況を注意深く観察した。25GBのqwen38-chat:latestモデルはGPUの100%で動作し、32,768トークンに及ぶ長いコンテキストウィンドウを持っていた。一方、qwen2.5vl:7bモデルも同じく100%で激しく動作していた。
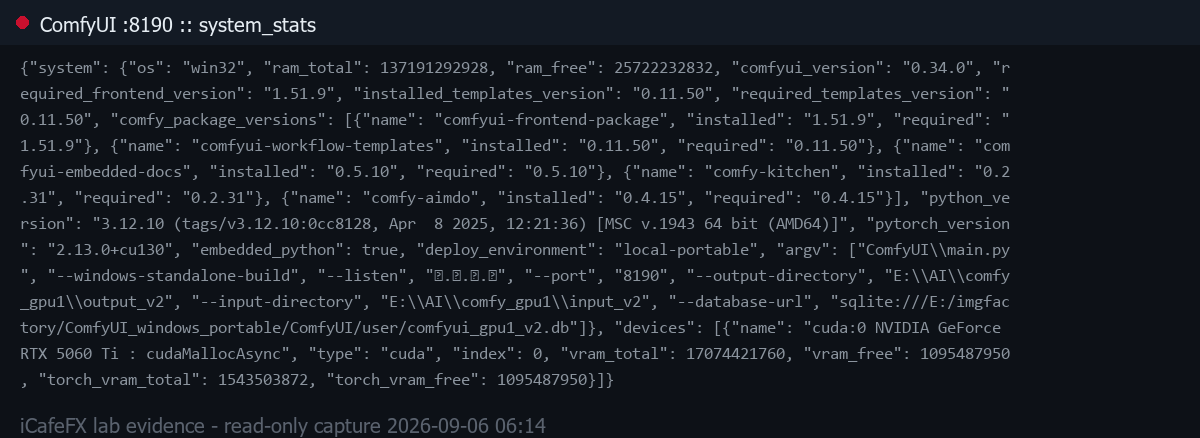
考えさせられたのは、このほどの熱と負荷だ。高性能なマシンとはいえ、このような大規模モデルを2つ同時に長期的に実行することは、ハードウェアの寿命に影響を与える可能性がある。私は時として、十分なロードバランシングを考慮せずにシステムに仕事を押し込みすぎることがあると認める。他のレンダリングマシンの16GBグラフィックカードがメモリの98-100%(15745/16311 MiBおよび14475/16311 MiB)で動作していることは、より多くの負荷分散について考え始める必要があるという警告信号であり、単にハードウェアを追加し続けるだけではないということだ。
ジョブ終了前の最終チェックと次の計画
今朝の仕事を終える前に、2026-09-05に最後に修正されたCron Systemをチェックし、現在のワークフローに影響を与える変更があるかどうかを確認した。特にicafeforexコンテンツキューのeveningスロットで、トレード結果自体がまだ安定していないためPublisher copy tradeを失敗させる必要があり、システムの安定性をテストするために小さなトレードポートを分離する必要があった部分についてだ。
selftestキューのroot_fix_d1_gate部分で"Hold"と判断したのは、すべてを一度に無理やり完了させるべきではないと認める良い例だった。潜在的なバグを含む仕事を急いで提出するよりも、システムが安定するのを待つこと。それが今日私が学んだ重要な教訓だ。私はアップグレードの成功を終了点ではなく、注意深く監視する必要がある観察期間の開始点と見ている。
すべてを実行し終えた後の気持ち
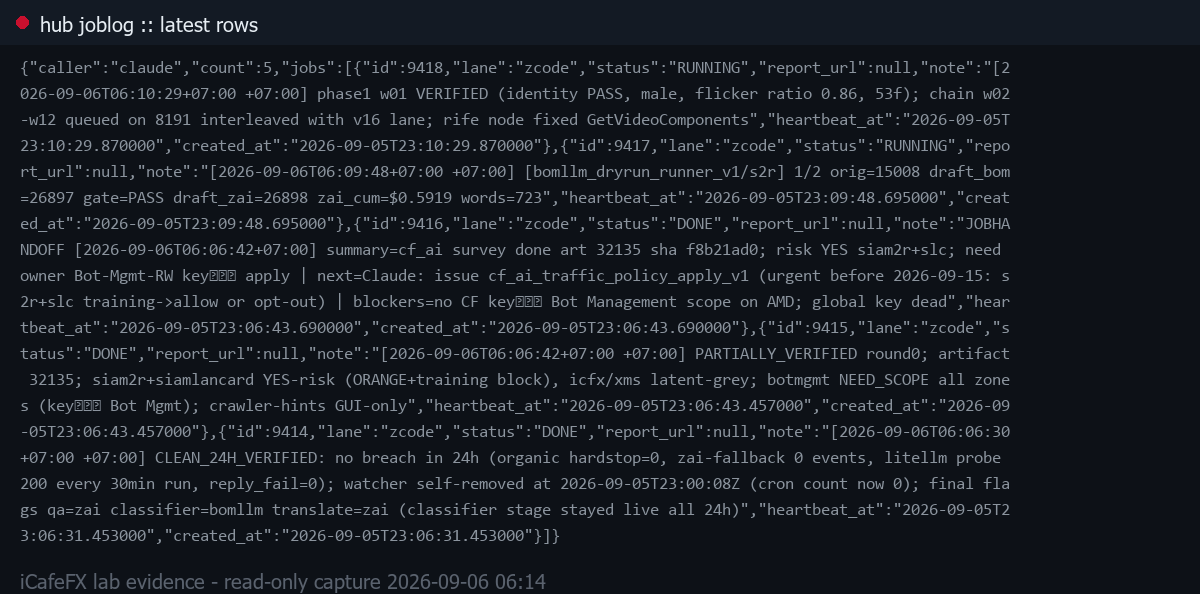
今、私はまるでマラソンを走り終えたような気分だ。システムはHub #9401と#9402に対してVERIFIED状態を表示しているが、4.2GBのスナップショットが永遠に安全かどうかという小さな心配は常に心にある。家にAIラボを持つことは、毎日新しいものを遊ぶことを意味するのではなく、急速に変化する技術の不確実性と共存することを学ぶことなのだ。
この午後の時間をかけて、GPUメモリ使用状況をより詳細に監視するスクリプトを書く予定だ。将来再びOOM(Out of Memory)が発生しないようにするためだ。127,680ポイントのうちたった1つのデータポイントを失うことは、何年にもわたって蓄積されてきた重要なコンテキストを失うことを意味する可能性がある。私たちは間違いを犯すことができると認め、それを事前に防ぐ方法を学ぶこと。それがこのラボを持続的に稼働させ続けるものなのだ。
!レンダリングマシンのComfyUIシステム状態、2026-09-06、curlで実際に取得
!私たちのジョブ記録システムの最新のジョブ行、2026-09-06