Sáng nay tôi không thức dậy vì đồng hồ báo thức, mà thức dậy vì tiếng thông báo từ hàng đợi công việc hệ thống chạy qua màn hình nước mắt của Docker Hub.
Khi con số 127.680 điểm cho chúng ta biết rằng điều gì đó đã thay đổi
Tôi vừa mới nâng cấp Qdrant lên phiên bản 1.19.1 xong vào sáng nay. Đây không phải là một bản cập nhật thông thường, mà là một cuộc phẫu thuật lớn ảnh hưởng đến sức khỏe của toàn bộ cơ sở dữ liệu vector của chúng ta. Những con số hiện ra trên màn hình là healthz và readyz trả về trạng thái 200, nghĩa là hệ thống sẵn sàng hoạt động hoàn toàn. Nhưng điều khiến tôi phải nín thở trong chốc lát là số lượng collection đầy đủ 12/12 điểm, tổng cộng có dữ liệu tích lũy lên tới 127.680 points - một con số rất lớn đối với homelab nhỏ bé của chúng ta.
Lần nâng cấp này không chỉ thay đổi phiên bản, mà còn là việc kiểm tra tính toàn vẹn của Snapshot 4.2GB mà chúng ta lưu trữ làm phương án dự phòng. Tôi phải chắc chắn rằng không có lỗi nào, dù chỉ một lỗi duy nhất trong phần logo hoặc cấu trúc dữ liệu, vì nếu có bất kỳ điểm nào bị hỏng dù chỉ một chút, việc tìm kiếm dữ liệu trong tương lai có thể cho kết quả sai lệch hoàn toàn. Tất cả những điều này xảy ra trong thời gian ngắn, nhưng áp lực đủ lớn để làm mồ hôi thấm ướt thái dương.
Hai bộ Docker Compose khiến tôi đau đầu đến mức phải ngồi uống cà phê
Vấn đề chính khiến lần nâng cấp này không suôn sẻ là việc quản lý 5 container chạy dưới hai bộ Docker Compose khác nhau. Tôi từng nghĩ hệ thống của chúng ta được thiết kế đủ tốt để tự quản lý, nhưng thực tế là khi có thay đổi phiên bản lớn, sự phụ thuộc chéo giữa các dịch vụ dễ gây ra Race Condition.
Tôi phải tạm dừng tất cả dịch vụ để ngăn xung đột Port và Volume bị Mount chồng lên nhau. Đây không phải là vấn đề kỹ thuật phức tạp vượt quá khả năng, mà là vấn đề về sự cẩn thận cần thiết cao. Tôi dành phần lớn thời gian để kiểm tra Log xem có lỗi nào trong giai đoạn Transition không, đặc biệt là phần SearXNG phiên bản 2026.9.5-c7f3080aa phải hoạt động cùng Qdrant một cách chặt chẽ. Việc mọi thứ vượt qua Gate q1 đến q4 mà không có cảnh báo lỗi nào là điều khiến tôi nhẹ nhõm nhất.
Bài học từ GPU nóng rực và mô hình nặng nề
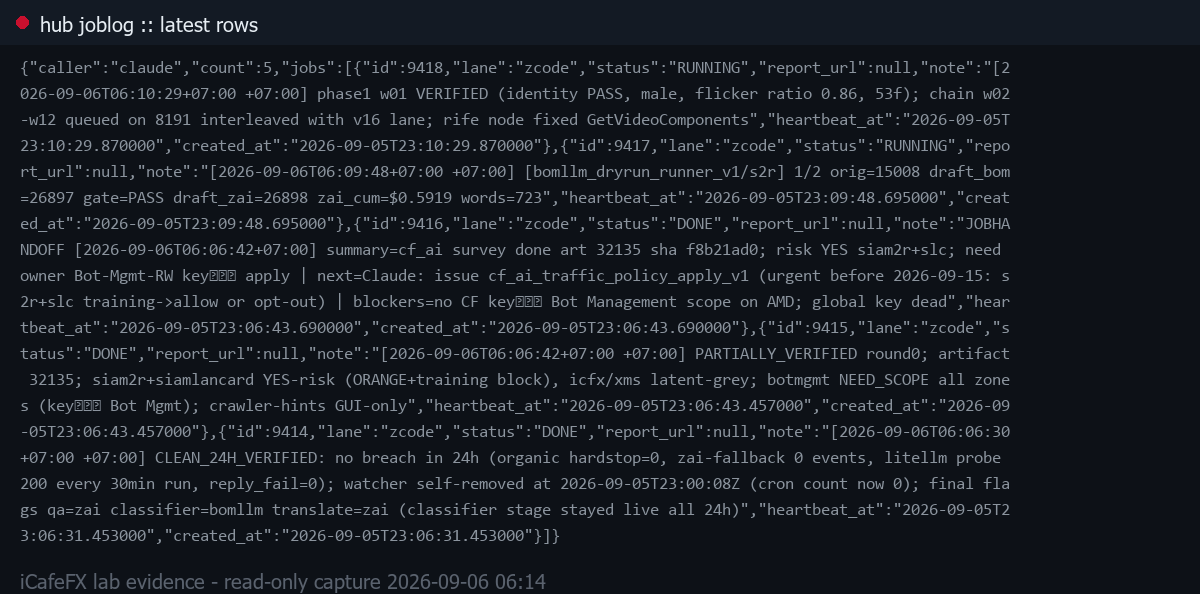
Trong khi hệ thống backend đang chạy Hub #9403 ở trạng thái RUNNING từ 05:48 sáng, tôi đã quan sát sát sao việc sử dụng tài nguyên của máy Mac Mini M4 Pro. Mô hình qwen38-chat:latest 25GB hoạt động ở 100% GPU với Context Window dài tới 32.768 Tokens, trong khi bên kia mô hình qwen2.5vl:7b cũng hoạt động nặng không kém ở 100%.
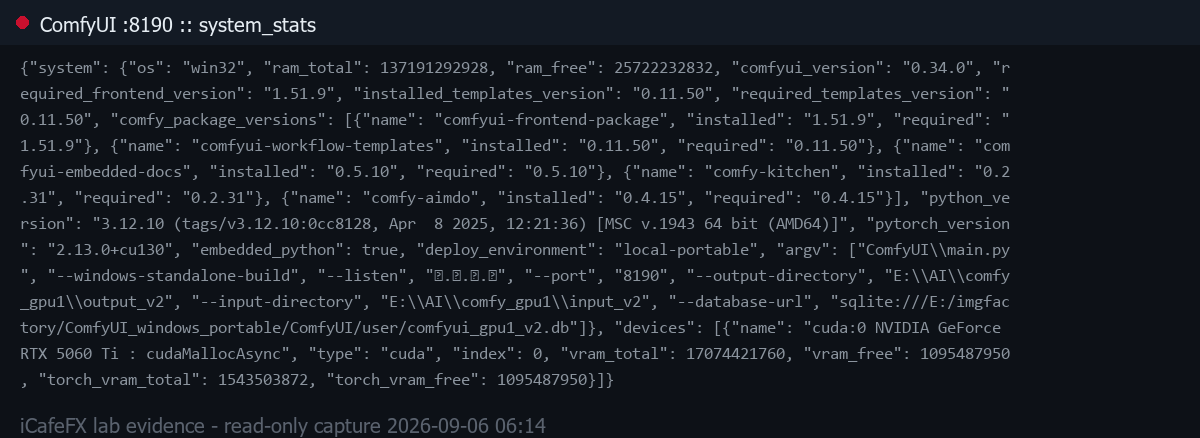
Điều khiến tôi phải dừng lại suy nghĩ là nhiệt độ và tải công việc cao như vậy. Dù là máy hiệu suất cao, nhưng việc chạy hai mô hình lớn cùng lúc như thế này trong thời gian dài có thể ảnh hưởng đến tuổi thọ phần cứng. Tôi thừa nhận đôi khi chúng ta có thể quá vội vàng trong việc đẩy công việc vào hệ thống mà không tính đến Load Balancing đủ tốt. Việc card đồ họa 16GB trên máy render khác hoạt động ở 98-100% bộ nhớ (15745/16311 MiB và 14475/16311 MiB) là dấu hiệu cảnh báo rằng chúng ta cần bắt đầu nghĩ về việc phân tán tải nhiều hơn, không chỉ đơn giản là thêm phần cứng.
Kiểm tra cuối cùng trước khi đóng job và kế hoạch tiếp theo
Trước khi kết thúc công việc sáng nay, tôi đã kiểm tra Cron System được chỉnh sửa lần cuối vào ngày 2026-09-05 xem có thay đổi nào ảnh hưởng đến Workflow hiện tại không, đặc biệt là phần hàng đợi nội dung icafeforex slot evening phải Fail Publisher copy trade vì kết quả giao dịch vẫn chưa ổn định, khiến tôi phải tách một port giao dịch nhỏ để kiểm tra độ ổn định của hệ thống trước.
Quyết định "Hold" ở phần root_fix_d1_gate của hàng đợi selftest là một ví dụ tốt về việc chấp nhận rằng đôi khi chúng ta không nên cố gắng hoàn thành mọi thứ cùng lúc. Chờ đợi để hệ thống ổn định hơn thay vì vội vàng gửi công việc có thể chứa Bug ẩn là bài học quan trọng tôi rút ra hôm nay. Tôi không xem việc nâng cấp thành công là điểm kết thúc, mà là điểm bắt đầu của giai đoạn quan sát cần theo dõi chặt chẽ.
Cảm giác sau khi chạy xong tất cả
Bây giờ tôi cảm thấy như vừa chạy xong một cuộc marathon. Mặc dù hệ thống đã hiển thị trạng thái VERIFIED cho Hub #9401 và #9402, nhưng những lo lắng nhỏ vẫn luôn tồn tại trong tâm trí rằng Snapshot 4.2GB đó có an toàn mãi không. Có một AI lab tại nhà không có nghĩa là được chơi đồ mới mỗi ngày, mà là học cách sống với sự bất định của công nghệ thay đổi nhanh.
Tôi dự định dành buổi chiều nay để viết Script giám sát việc sử dụng bộ nhớ GPU chi tiết hơn, để ngăn chặn OOM (Out of Memory) xảy ra lại trong tương lai. Vì việc mất dù chỉ một điểm dữ liệu từ 127.680 points cũng có thể đồng nghĩa với việc mất đi bối cảnh quan trọng đã tích lũy qua nhiều năm. Chấp nhận rằng chúng ta có thể sai và học cách ngăn chặn nó trước là điều khiến lab này tiếp tục vận hành bền vững.
!Trạng thái hệ thống ComfyUI trên máy render, ngày 2026-09-06, lấy bằng curl thực tế
!Hàng đợi công việc gần nhất từ hệ thống ghi log của chúng ta, ngày 2026-09-06