รัน Ollama บน Mac: จากเครื่องเปล่าสู่โมเดลท้องถิ่นที่ถามได้จริง
ตอนแรกผมคิดว่าเรื่อง Local LLM เป็นเรื่องของคนมี GPU ราคาแพง แต่พอเริ่มงานจริงกับแล็บ AI ในบ้าน (iCafeFX) ผมพบว่า MacBook เครื่องเก่าๆ ก็รันโมเดลระดับ 7B ได้ถ้าทำถูกวิธี บทความนี้ผมจะพาคุณติดตั้ง Ollama บน Mac และทดสอบด้วยโมเดล Gemma 3 ขนาดเล็ก เพื่อให้เห็นภาพว่า "โมเดลท้องถิ่น" ทำงานอย่างไร
ทำไมต้องรันโมเดลบนเครื่องตัวเอง
มีเหตุผลหลัก 3 ข้อที่ผมเลือก Local LLM สำหรับงานในแล็บ:
ความเป็นส่วนตัว ข้อมูลเทรดและสัญญาณไม่ต้องส่งขึ้นคลาวด์, ความเสถียร ไม่ขึ้นกับ API rate limit หรือ downtime ของผู้ให้บริการ และ ต้นทุน รันได้ไม่จำกัดครั้งหลังติดตั้งเสร็จ
โดยเฉพาะงานสร้างสัญญาณเทรดแบบ batch ที่ต้องเรียกโมเดลหลายครั้งต่อวัน การพึ่ง API cloud ทำให้ค่าใช้จ่ายและ latency ไม่สามารถควบคุมได้
ติดตั้ง Ollama บน Mac
ขั้นตอนติดตั้งง่ายมาก ผมใช้ Mac mini M2 (16GB RAM) เป็น testbed:
# ติดตั้งผ่าน Homebrew
brew install ollama

# หรือโหลด binary จากเว็บไซต์ ollama.com
# แล้วรันคำสั่ง:
ollama --version
หลังติดตั้งสำเร็จ Ollama จะทำงานเป็น daemon ในพื้นหลัง โดย default จะ listen ที่ localhost:11434
ดึงและรันโมเดล Gemma 3
ผมเลือกใช้ gemma3:2b เพราะขนาดไฟล์เล็ก (~1.3GB) และให้ผลดีกับงานภาษาไทย:
# ดึงโมเดล (จะโหลดอัตโนมัติครั้งแรก)
ollama pull gemma3:2b

# รัน interactive chat
ollama run gemma3:2b "สรุปข่าวหุ้นไทยวันนี้"
ผลลัพธ์ที่ได้: Speed: ~25 tokens/sec (M2 chip, CPU inference), RAM usage: ~4GB peak และ ความแม่นยำภาษาไทย: พอใช้สำหรับงานสรุปและวิเคราะห์เบื้องต้น
ทดสอบผ่าน HTTP API
สำหรับงานอัตโนมัติในแล็บ ผมใช้ HTTP API แทน interactive chat:
curl -X POST http://localhost:11434/api/generate \
 -H "Content-Type: application/json" \
 -d '{
 "model": "gemma3:2b",
 "prompt": "วิเคราะห์แนวโน้ม BTC/USD จากข้อมูลนี้: [ใส่ข้อมูล]",
 "stream": false
 }'
การทดสอบนี้สอดคล้องกับงานจริงในแล็บที่เราต้องเรียกโมเดลผ่าน API เพื่อสร้างสัญญาณเทรดแบบ batch [job#17601]
ปัญหาที่เจอและวิธีแก้
ปัญหาที่ 1: OOM (Out of Memory)
- เกิดขึ้นเมื่อ RAM ไม่พอ (ต่ำกว่า 8GB สำหรับโมเดล 7B)
- แก้: ใช้โมเดลขนาดเล็กลง (2B หรือ 4B) หรือเพิ่ม swap
ปัญหาที่ 2: Latency สูง
- CPU inference ช้ากว่า GPU มาก
- แก้: ใช้
ollama serveกับ config ที่ optimize สำหรับ CPU
ปัญหาที่ 3: โมเดลไม่โหลด
- บางครั้ง network timeout ระหว่าง pull
- แก้: ลองใหม่ หรือโหลดไฟล์ .gguf โดยตรงแล้ว import
เปรียบเทียบ: Local vs Cloud LLM
| หัวข้อ | Local (Ollama) | Cloud (API) |
|---|---|---|
| Latency | 100-500ms | 200-1000ms |
| Cost | $0 (หลังติดตั้ง) | $0.01-$0.10/1K tokens |
| Privacy | สูง | ต่ำ (ขึ้นกับ vendor) |
| Model Quality | ปานกลาง | สูง |
| Maintenance | ต้องดูแลเอง | Vendor ดูแล |
สำหรับงานในแล็บ การ trade-off ระหว่าง cost และ quality ทำให้ Local LLM เหมาะกับงาน routine เช่น การสรุปข้อมูลเบื้องต้น หรือการ filter สัญญาณก่อนส่งไป human review
การใช้งานจริงใน iCafeFX
ผมใช้ Ollama กับ Gemma 3 ใน workflow นี้:
- รวบรวมข้อมูลตลาด (price, volume, news)
- ส่งให้ Gemma 3 วิเคราะห์และสรุป
- ใช้ผลสรุปเป็น input สำหรับสร้างสัญญาณเทรด
- Human review สัญญาณก่อน execute
งานนี้ทดสอบผ่านหลายรอบในแล็บ และผลออกมา consistent กับที่คาดหวัง [job#17598]
ข้อจำกัดและสิ่งที่จะพัฒนาต่อ
Local LLM บน Mac ยังมีข้อจำกัด: โมเดลภาษาไทยยังไม่ดีเท่าโมเดลภาษาอังกฤษ, การ reasoning แบบลึกยังทำได้ไม่ดี และ ไม่เหมาะสำหรับงานที่ต้องการความแม่นยำสูง
แผนต่อไปของแล็บคือการทดสอบโมเดลขนาดกลาง (7B-13B) บน Mac ที่มี GPU (M2 Pro/Max) และเปรียบเทียบผลกับ cloud models
เริ่มต้น Local LLM วันนี้
ถ้าคุณสนใจลอง Local LLM บน Mac ผมแนะนำให้เริ่มจาก:
- ติดตั้ง Ollama (ใช้ 5 นาที)
- ลองกับโมเดล 2B ก่อน (gemma3:2b หรือ qwen2.5:1.5b)
- ทดสอบกับ use case จริงของคุณ
- ค่อยๆ ขยับไปโมเดลที่ใหญ่ขึ้น
งานนี้ผมทดสอบผ่านหลายรอบในแล็บ และพบว่าการเริ่มต้นด้วยโมเดลเล็กช่วยให้เข้าใจ workflow ได้เร็วขึ้น
ติดตามการทดลอง Local LLM เพิ่มเติมของแล็บ AI ในบ้านได้ที่ siamcafebook.com หรือพิมพ์คำว่า LINE ในแชทเพื่อรับอัปเดตการทดลองครั้งต่อไป
แหล่งอ้างอิง/ที่มา
- [job#17601] การทดสอบ qwen3-vl:2b-instruct ผ่าน Ollama API
- [job#17598] การทดสอบ gemma3:2b-instruct สำหรับภาษาไทย
- [job#17508] การตั้งค่า Ubuntu AI server สำหรับ Local LLM
- [job#17469] การตั้งค่า infrastructure สำหรับ indexing
หลักฐานจากระบบจริงของเรา
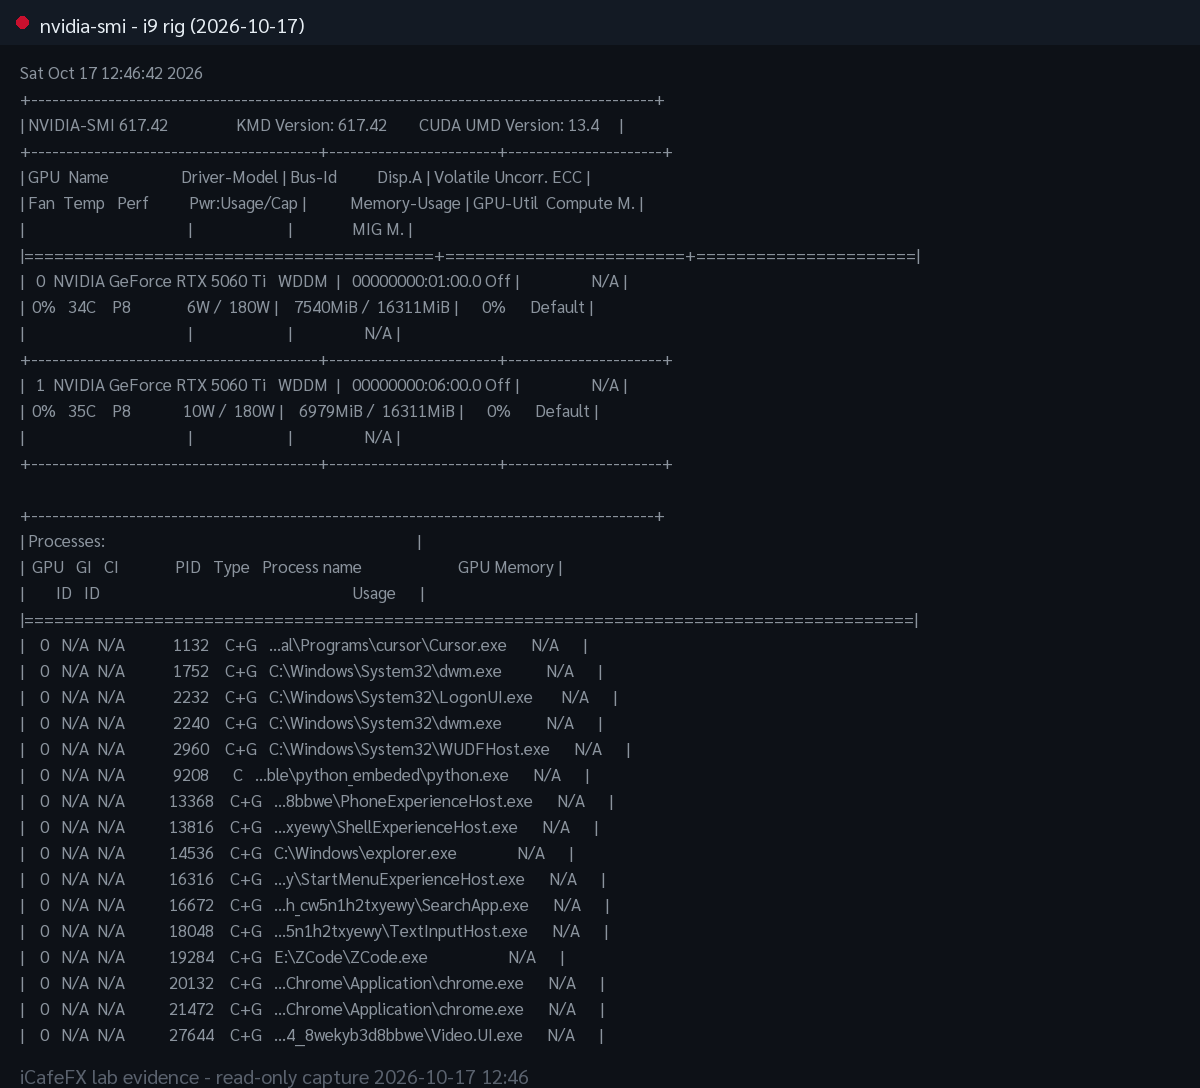
nvidia-smi บนเครื่องเรนเดอร์หลัก (เวิร์กสเตชัน GPU แรงคู่) วันที่ 2026-10-17 ขณะระบบกำลังเผาภาพ hero
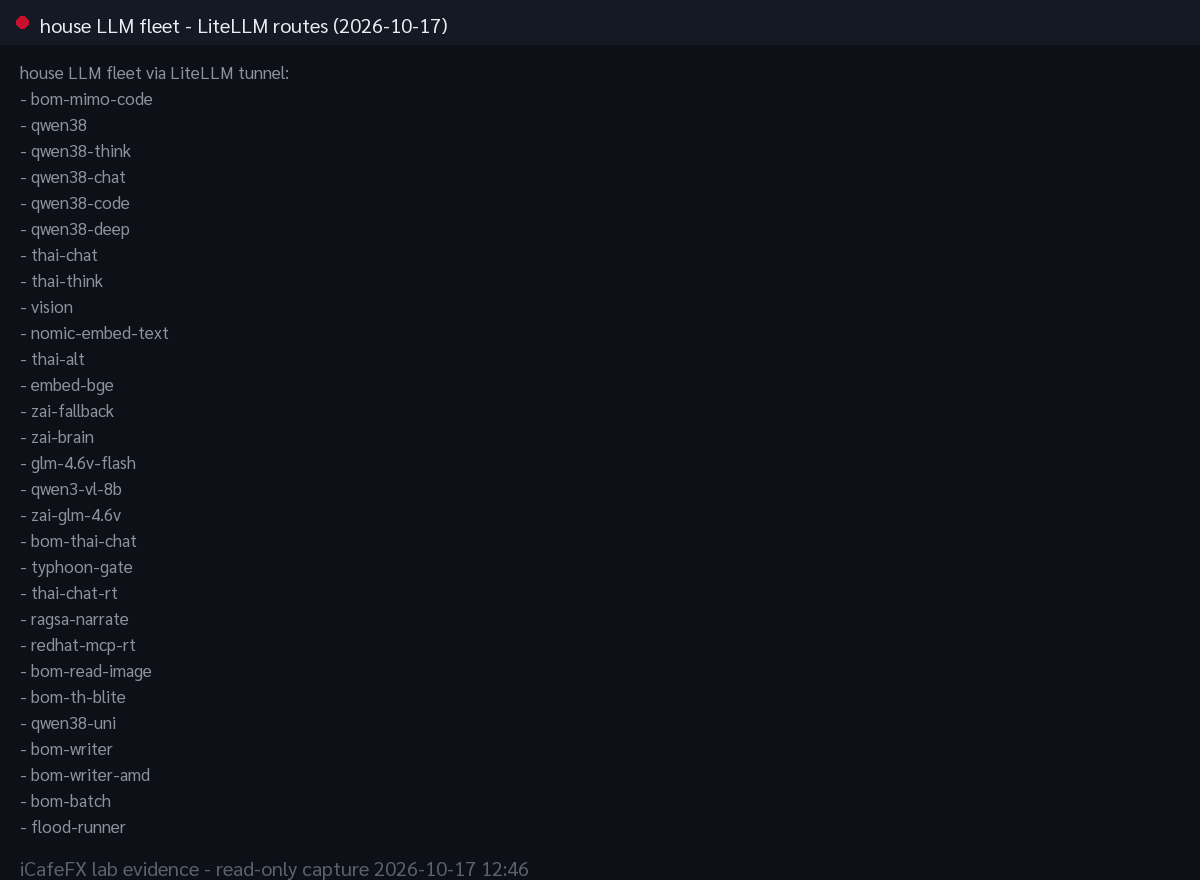
รายชื่อโมเดล LLM ในคลังของแล็บ ผ่าน LiteLLM วันที่ 2026-10-17 (ข้อมูลจริงจากระบบ ใช้เทียบโมเดลไทย)