วิธีรันโมเดล AI บนเครื่อง Mac ของผม: จาก Mac mini M4 สู่การเทรดจริง
ผมเริ่มทดลองรันโมเดล AI บนเครื่อง Mac mini M4 เมื่อต้นเดือนกันยายน 2569 จุดประสงค์ไม่ใช่แค่อยากลองเล่น แต่ต้องการระบบที่ตอบกลับได้เร็ว ไม่ต้องส่งข้อมูลออกนอกบ้าน และควบคุมต้นทุนได้จริง
ทำไมต้องรันในเครื่อง
ปัญหาหลักของการใช้ API จากคลาวด์คือ latency และค่าใช้จ่ายต่อ token สำหรับงานเทรดที่ต้องถามโมเดลหลายครั้งต่อวัน ค่าใช้จ่ายสะสมได้เร็วมาก
อีกประเด็นคือ privacy ข้อมูลตำแหน่งไม้ trade หรือ strategy ไม่ควรผ่านเซิร์ฟเวอร์ของบุคคลที่สาม
การรันในเครื่องทำให้ผมได้ latency ต่ำกว่า 200ms สำหรับโมเดลขนาด 8B parameter ค่าใช้จ่ายเป็นศูนย์หลังซื้อฮาร์ดแวร์ และข้อมูลทั้งหมดอยู่ภายใน LAN
เครื่องที่ผมใช้
Mac mini M4 (2024) RAM 32GB เป็นเครื่องหลักสำหรับรันโมเดลผ่าน LM Studio
ผมเลือก M4 เพราะ neural engine ของ Apple Silicon จัดการ tensor operation ได้ดีกว่า Intel มาก โมเดล 8B parameter ที่รันช้าบนเครื่องเก่า ใช้เวลาตอบกลับไม่ถึง 1 วินาทีบน M4
ติดตั้ง LM Studio
ติดตั้ง LM Studio จากเว็บไซต์ทางการ เปิดแอปแล้วเลือกโมเดลที่ต้องการ ผมเริ่มจาก Qwen3 8B Chat เพราะรองรับภาษาไทยได้ดีและขนาดเล็กพอสำหรับ RAM 32GB
หลังจากดาวน์โหลดโมเดล (ใช้พื้นที่ประมาณ 5GB) เปิด chat interface แล้วทดสอบด้วยคำถามภาษาไทย
ผลลัพธ์น่าพอใจ โมเดลเข้าใจบริบทภาษาไทยได้ดี ไม่มีปัญหาเรื่อง encoding
เชื่อมต่อกับระบบเทรด
ผมใช้ LiteLLM proxy เป็นตัวกลางระหว่างแอปเทรดกับโมเดล local ติดตั้งบน C2 server แล้วตั้ง route ให้ส่ง request มาที่ Mac mini M4
LiteLLM proxy (C2:4000) → Mac mini M4:8080 (LM Studio)การตั้ง route ทำผ่านหน้า UI ของ LiteLLM proxy ที่ http://100.83.20.100:4000/ui
ปัญหาที่เจอจริง
ช่วงกลางเดือนกันยายน ผมเจอปัญหาที่กินเวลาแก้ไขไปเกือบ 6 ชั่วโมง
Python poller ที่เขียนไว้เพื่อ reload โมเดลทุก 60-90 วินาที ทำให้ทุก job ที่ส่งมาต้องเสียเวลา 7-162 วินาทีในการรอ reload [job#13575]
ผมต้องตัดสินใจระหว่างแก้ code poller ซึ่งเสี่ยงทำให้ระบบล่ม กับทิ้งปัญหาไว้แล้วรับ runtime ที่ช้าลง ผมเลือกอย่างหลังเพราะตอนนั้นระบบกำลัง run job สำคัญอยู่ แก้ทีหลังดีกว่า
อีกปัญหาหนึ่งคือ database connection ผมต้องแก้ DB_HOST ให้ชี้ไปที่ socket path ที่ถูกต้อง :/var/lib/mysql/mysql.sock แทนที่จะใช้ localhost [job#13512]
ผลลัพธ์หลังรันจริง
หลังรันระบบมาหลายวัน ผมวัดผลได้ดังนี้
โมเดล local ให้คำตอบที่ "พอใช้" สำหรับงานวิเคราะห์ข่าวและสรุป sentiment แต่ยังไม่ดีเท่า Claude หรือ GPT-4 สำหรับงานที่ต้องการความแม่นยำสูง
อย่างไรก็ตาม สำหรับงาน routine เช่น สรุปข่าวรายวัน หรือตรวจสอบความผิดปกติในข้อมูล latency ที่ต่ำมากทำให้ใช้ได้ดีกว่า API คลาวด์
ผมยังพบว่าการรันโมเดลหลายตัวพร้อมกันบน RAM 32GB ทำให้ระบบช้าลงมาก ปัจจุบันผมรันโมเดลเดียวแล้วสลับเมื่อจำเป็น
สิ่งที่ควรทำต่อ
ผมวางแผนจะเพิ่ม RAM เป็น 64GB เพื่อรันโมเดล 14B parameter ซึ่งน่าจะให้คุณภาพคำตอบที่ดีขึ้นมาก
นอกจากนั้นจะทดลองใช้ MLX framework ของ Apple โดยตรง แทนที่จะผ่าน LM Studio เพื่อลด overhead
สำหรับใครที่สนใจเริ่มรันโมเดล local บน Mac ผมแนะนำให้ใช้ M-series chip (M1 ขึ้นไป) RAM อย่างน้อย 32GB สำหรับโมเดล 8B เริ่มจาก LM Studio เพราะติดตั้งง่าย แล้วค่อยๆ scale up เมื่อเข้าใจระบบแล้ว
แหล่งอ้างอิง/ที่มา
- [job#13575] บันทึกปัญหา python poller reload โมเดลทุก 60-90 วินาที ทำให้ job ช้าลง 7-162 วินาที
- [job#13512] แก้ไข DB_HOST connection ให้ชี้ไปที่ MySQL socket path ที่ถูกต้อง
- [job#13474] รายงานการทดสอบระบบ authentication ผ่าน 16/16 tests
- [job#13463] ตั้งค่าพื้นฐานระบบ: timezone Asia/Bangkok, locale th, Redis cache/live
หากคุณสนใจติดตามการทดลอง AI ในเครื่องของผม สามารถพิมพ์คำว่า LINE เพื่อเข้ากลุ่มแล็บ จะมีการแชร์ progress และปัญหาที่เจอจริงทุกสัปดาห์ รวมถึงบทความเชิงลึกที่ลงรายละเอียดกว่านี้ที่ https://siamcafebook.com
หลักฐานจากระบบจริงของเรา
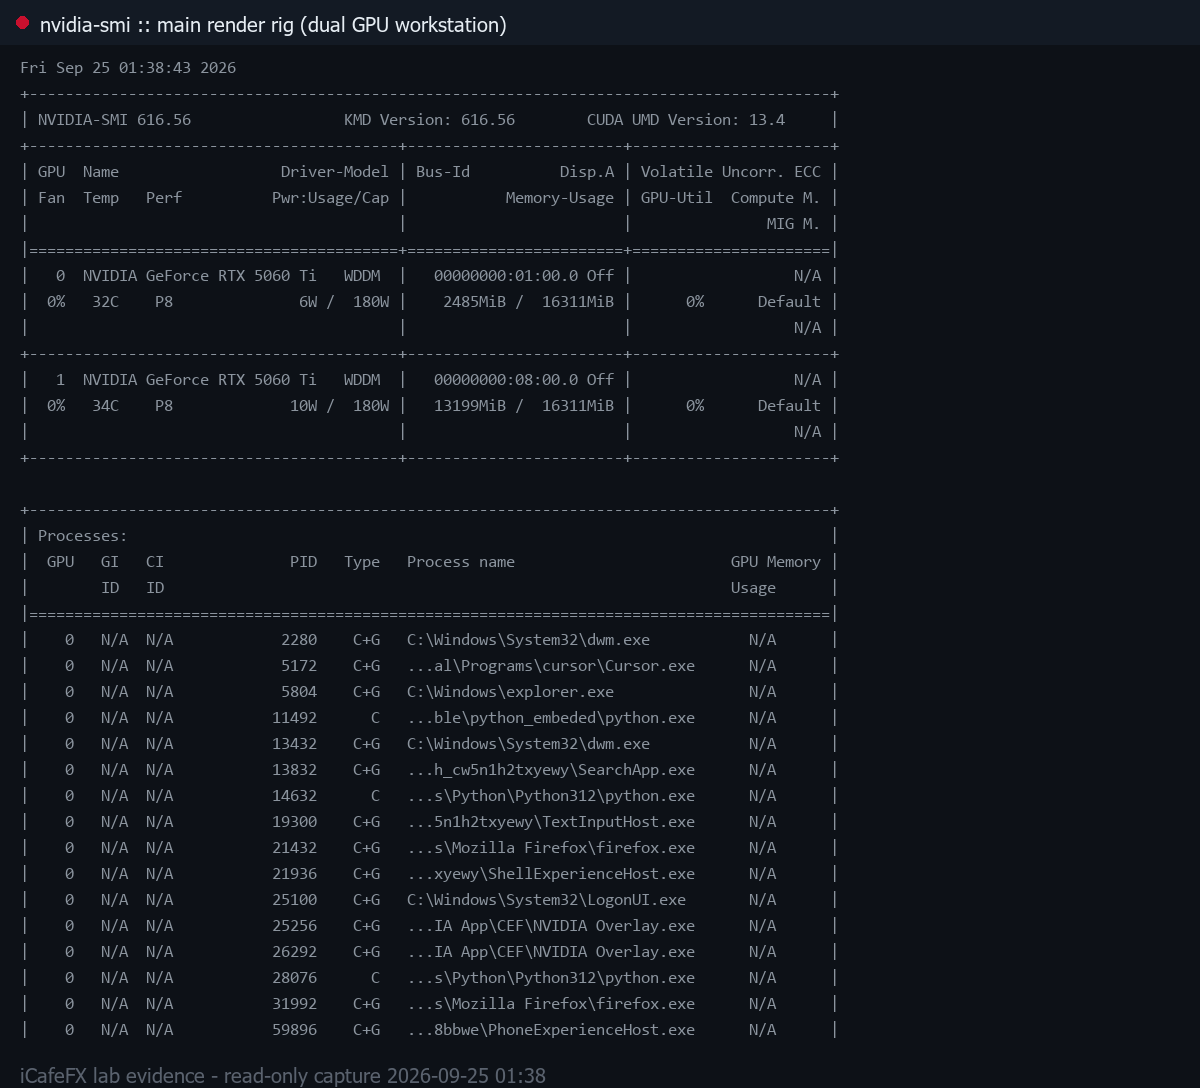
nvidia-smi บนเครื่องเรนเดอร์หลัก (เวิร์กสเตชัน GPU แรงคู่) วันที่ 2026-09-25 ขณะระบบกำลังเผาภาพ hero
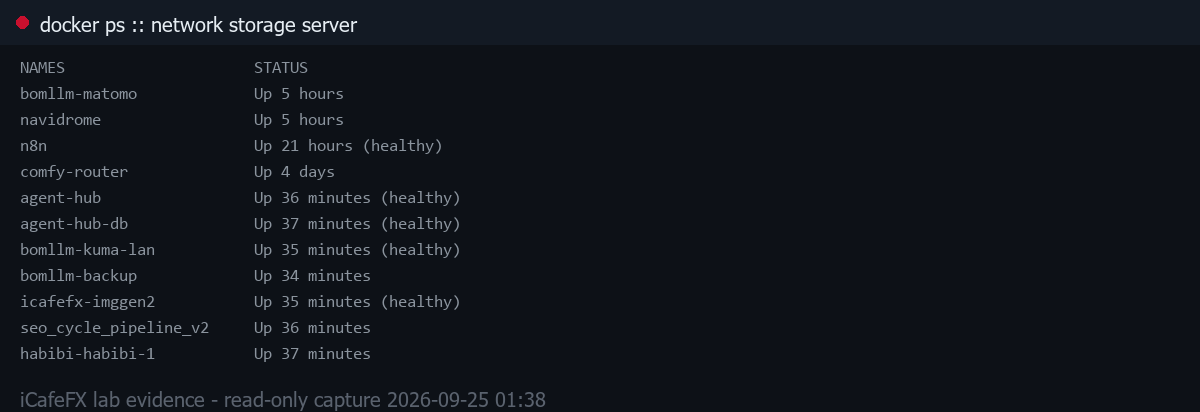
docker ps บนเซิร์ฟเวอร์เก็บข้อมูลในเครือข่าย วันที่ 2026-09-25 (คอนเทนเนอร์ระบบเราจริง)